模型評分服務操作步驟說明
歡迎點擊右側連結至新分頁觀看。 watch video
概述
本專案流程為評估語言模型,執行五大任務(英翻中、論文、書信、摘要、中翻英)或四大任務(公文、新聞稿、民眾陳情、模擬問答)的能力。使用者可自己選擇評估任務 (TASKS)、評估目標模型 (GEN MODEL)、裁判模型 (JUDGE MODEL),並回傳詳細評估結果與分數報告到使用者指定的 Git Repository。 本專案包含三條流程
-
模型回復生成 (gen): 使用內建的四大任務或五大任務題庫,讓欲評估的目標模型針對題目生成回復。
-
評估 (eval): 使用者自行代入四大任務或五大任務的模型回復檔案,流程使用內建相對應的評估Prompt,以使用者指定的裁判模型 (JUDGE MODEL) 對模型回復進行打分。
-
評估完整流程 (gen-eval): 模型回復生成 + 評估
-
專案執行位置:
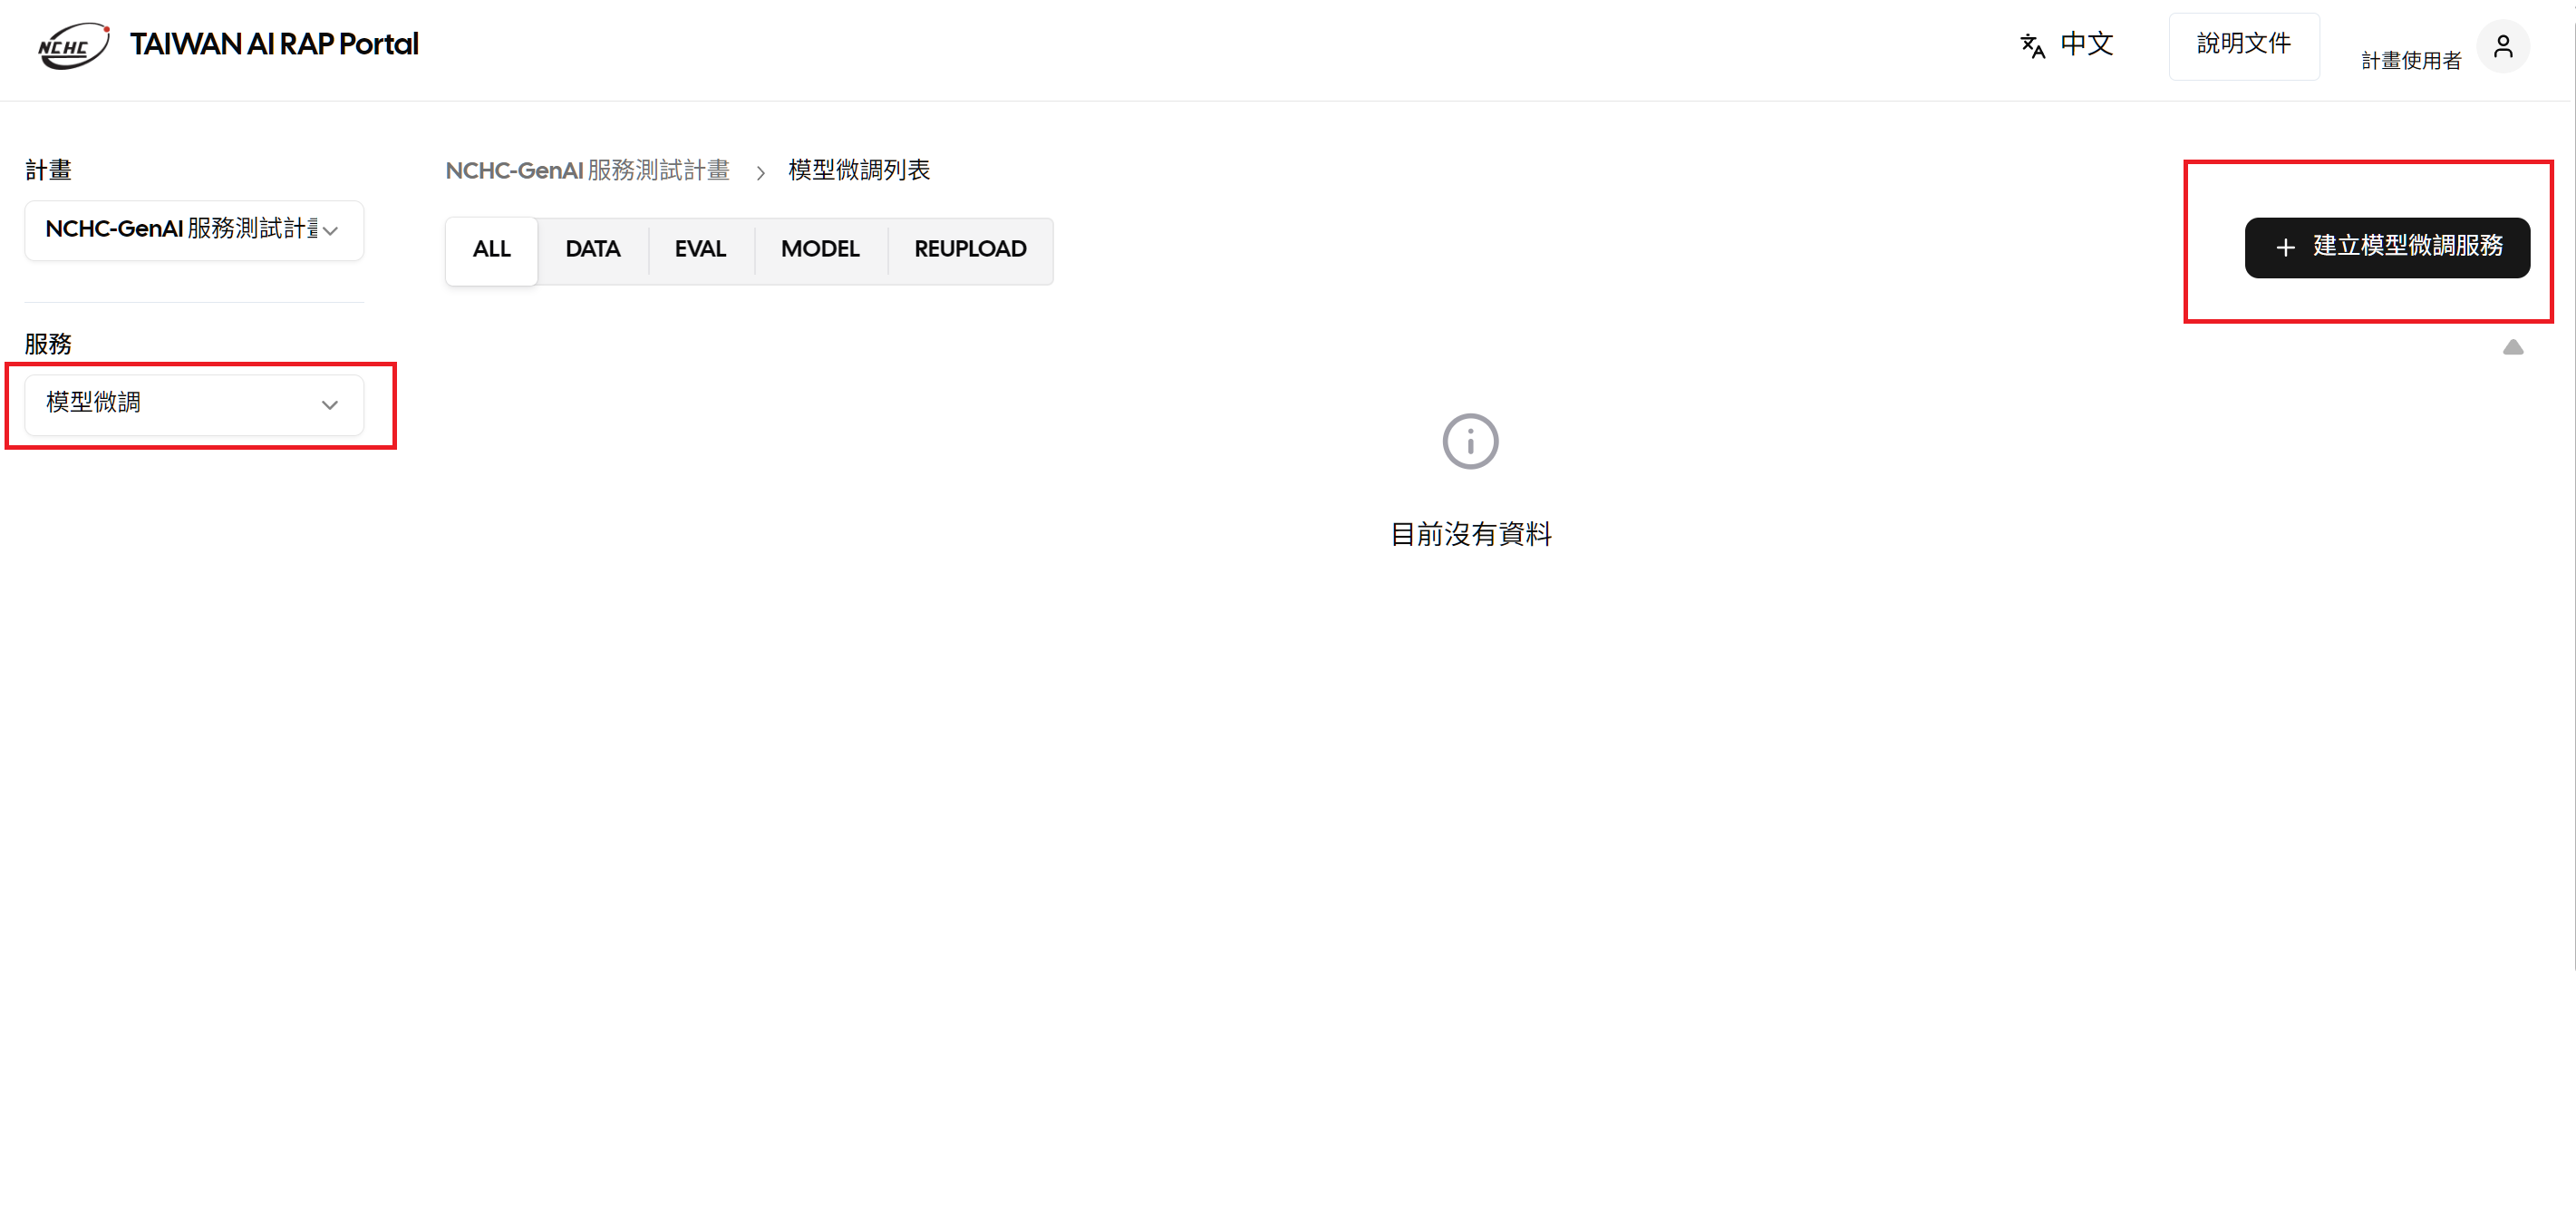
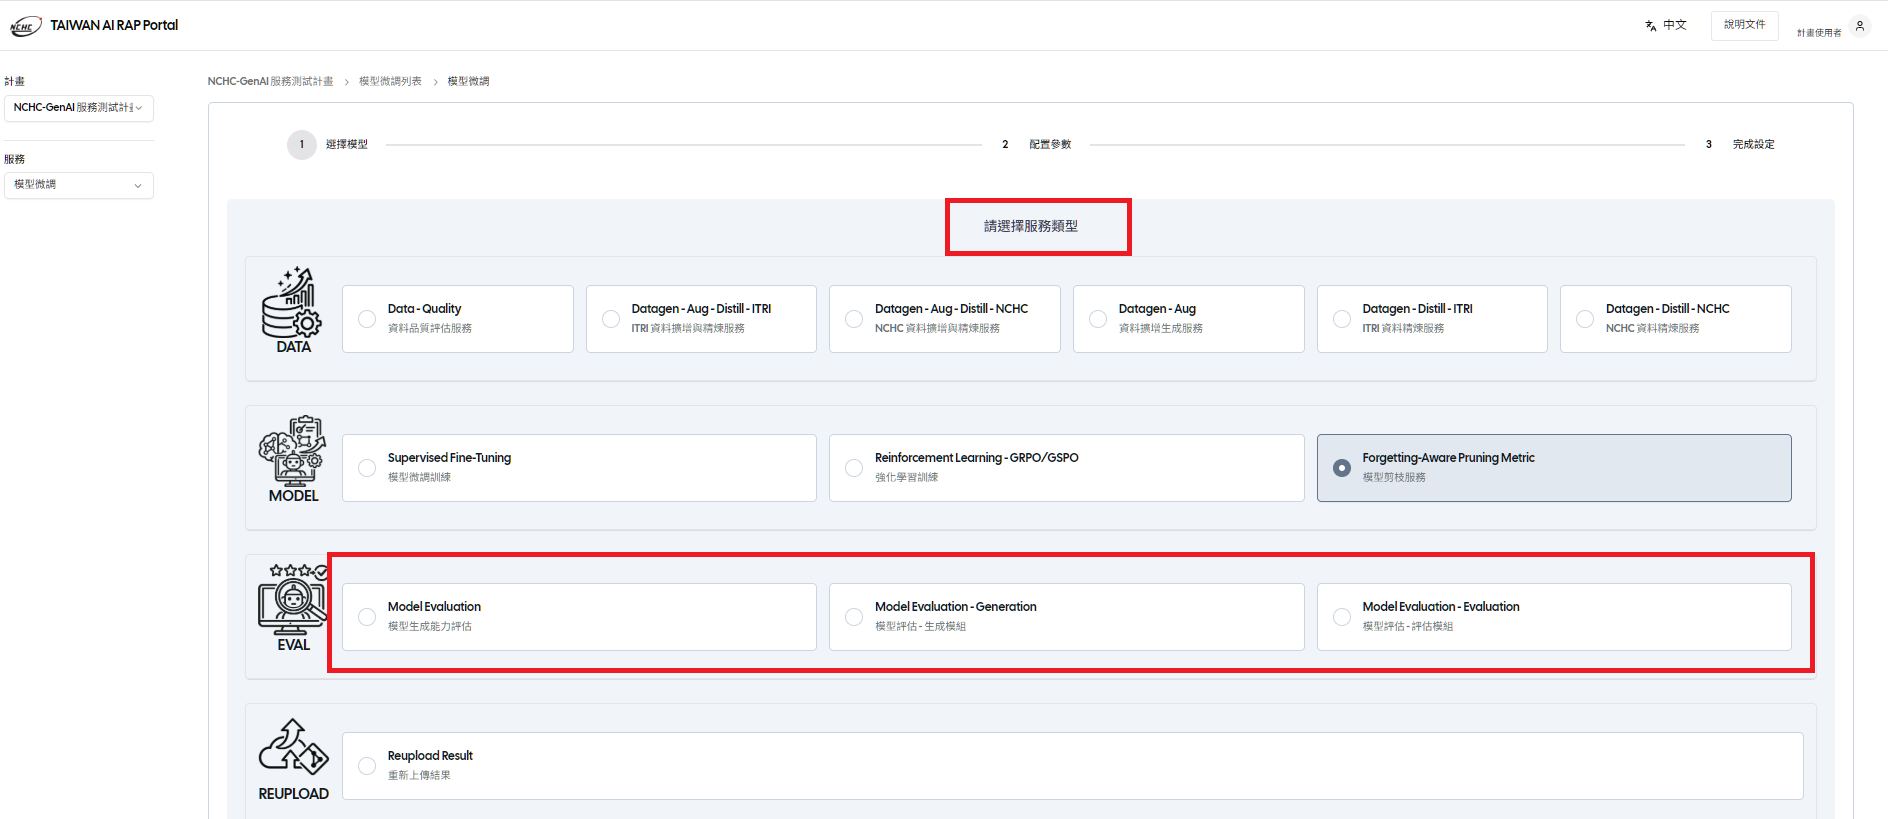
-
專案結構:
Model Evaluation
└── custom-run
    └──Generation               # 生成回覆
    └──Evaluation             # 評估生成回覆
└── run-all
└──Model Evaluation # 完整一條龍從頭執行到尾 -
使用說明: 前置需求
前置需求
GitLab 專案 (Repository)
- 請先自行建立專案
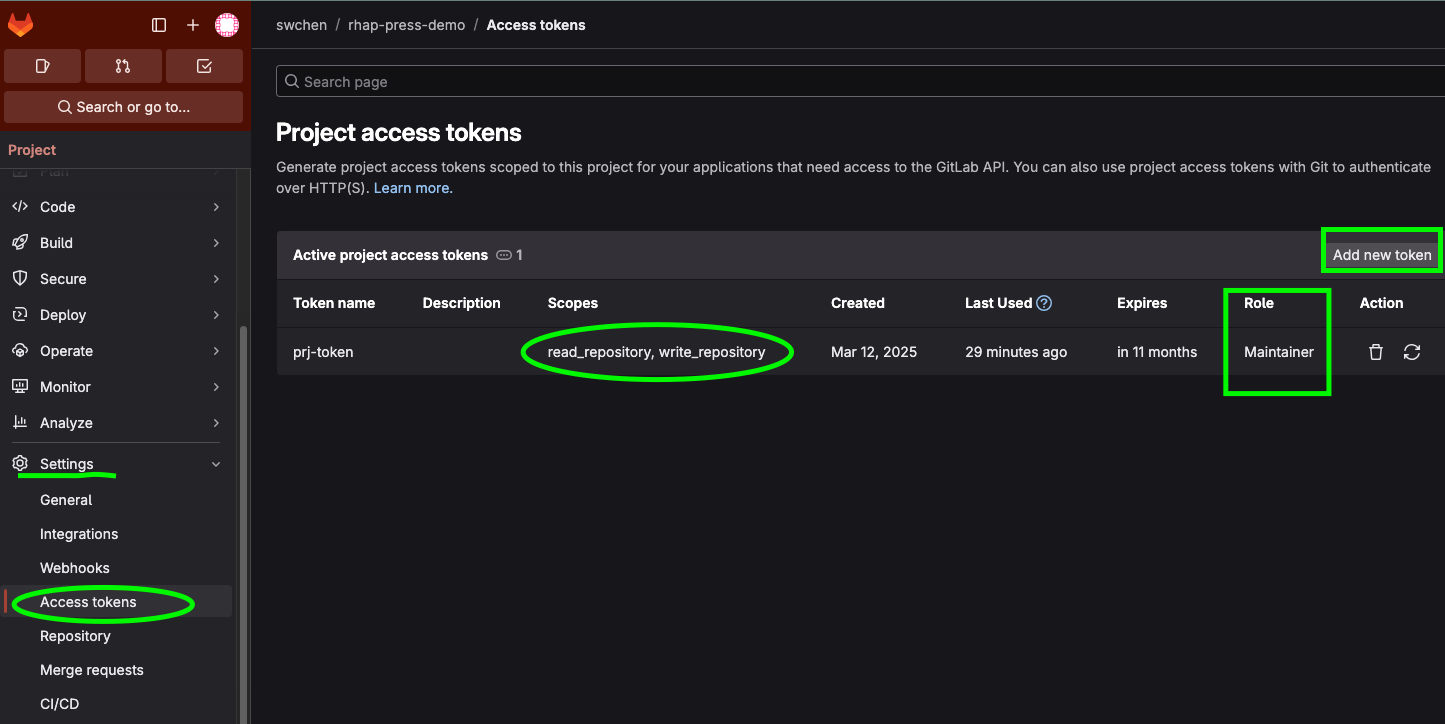
- 申請存取令牌(Access tokens)
(1) 申請方式:進入欲使用的專案 -> Settings -> Access tokens -> Add new token
(2) Scopes 選擇 read_repository, write_repository
(3) Role 選擇 Maintainer 或 Owner
(4) 存取令牌申請完成後,請務必存在安全的地方,離開頁面後便無法再取得
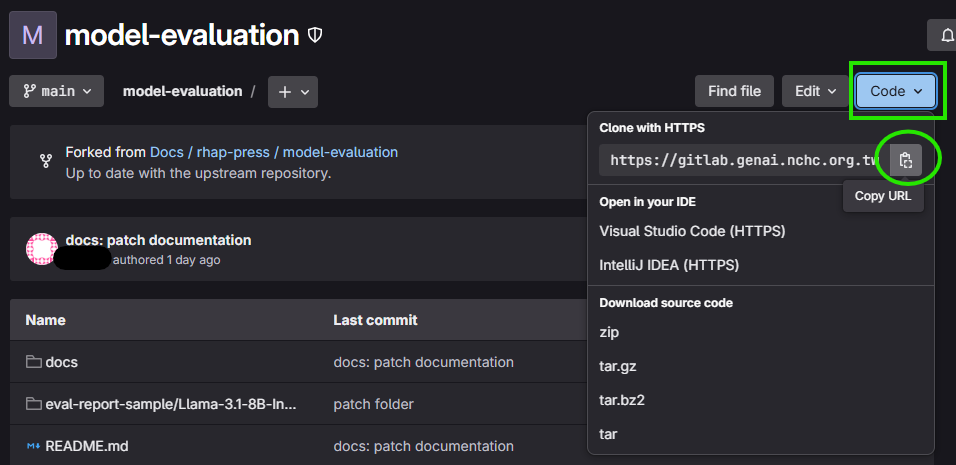
- 取得專案 URL
GIT_REPO_URL
- 建立儲存評估結果的目錄
GIT_REPORT_DIR
- 方法一(運用指令,請先下載Git CMD進行操作)
git clone <GIT_REPO_URL>
cd <git_repo_dir>
mkdir <GIT_REPORT_DIR> # 建立儲存結果的docs/image.png目錄
cd <GIT_REPORT_DIR>
touch .gitkeep # 建立佔位檔案(linux、MAC用)
copy nul <FILE_NAME_EXTENSION> # 建立佔位檔案(WINDOWS用)
git add .
git commit -m "你的提交訊息"
git push origin main # 推回你的遠端專案 - 方法二(運用GUI)
-
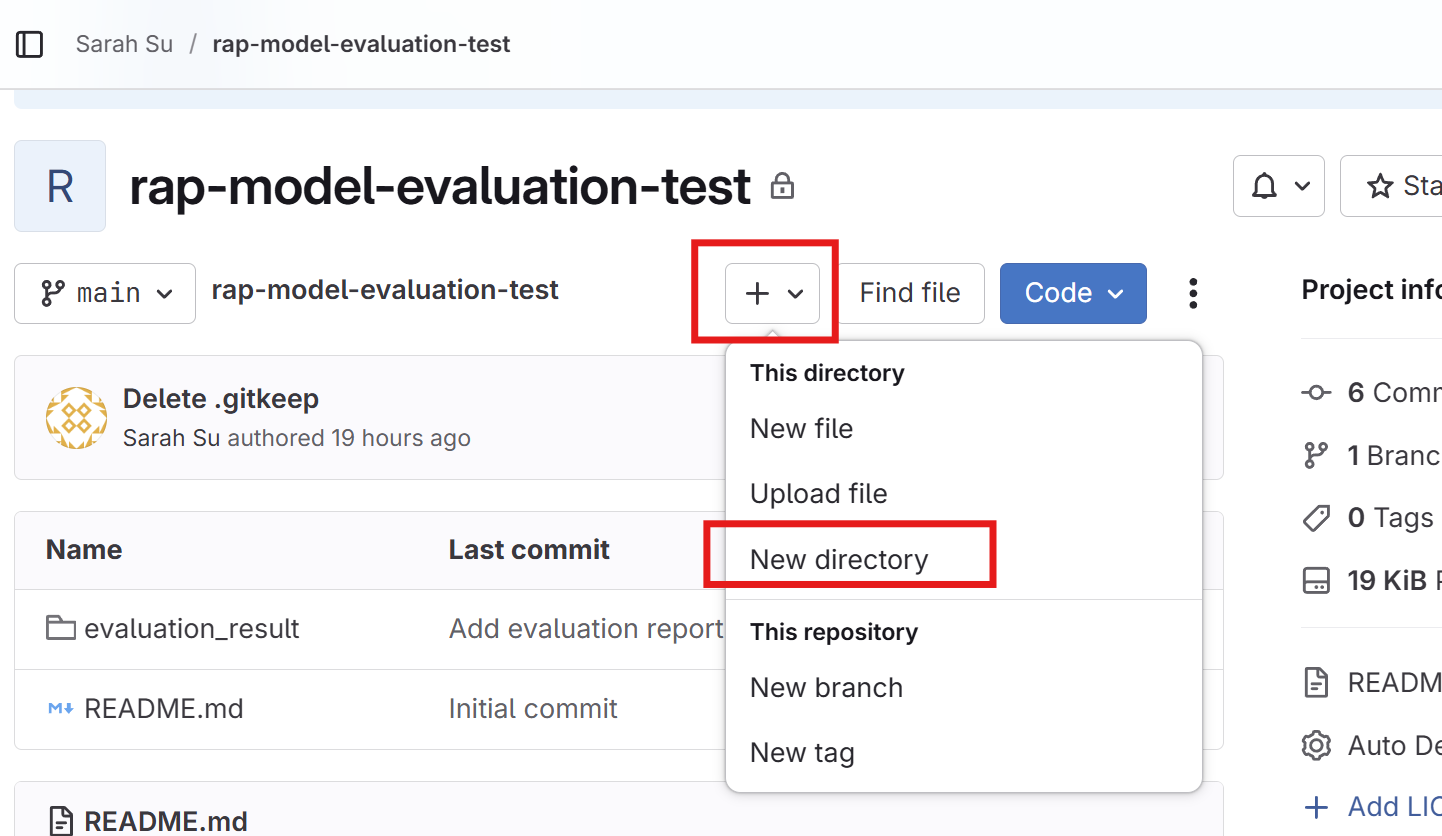
至專案首頁點擊 "+" 按鈕並選擇"New directory"
-
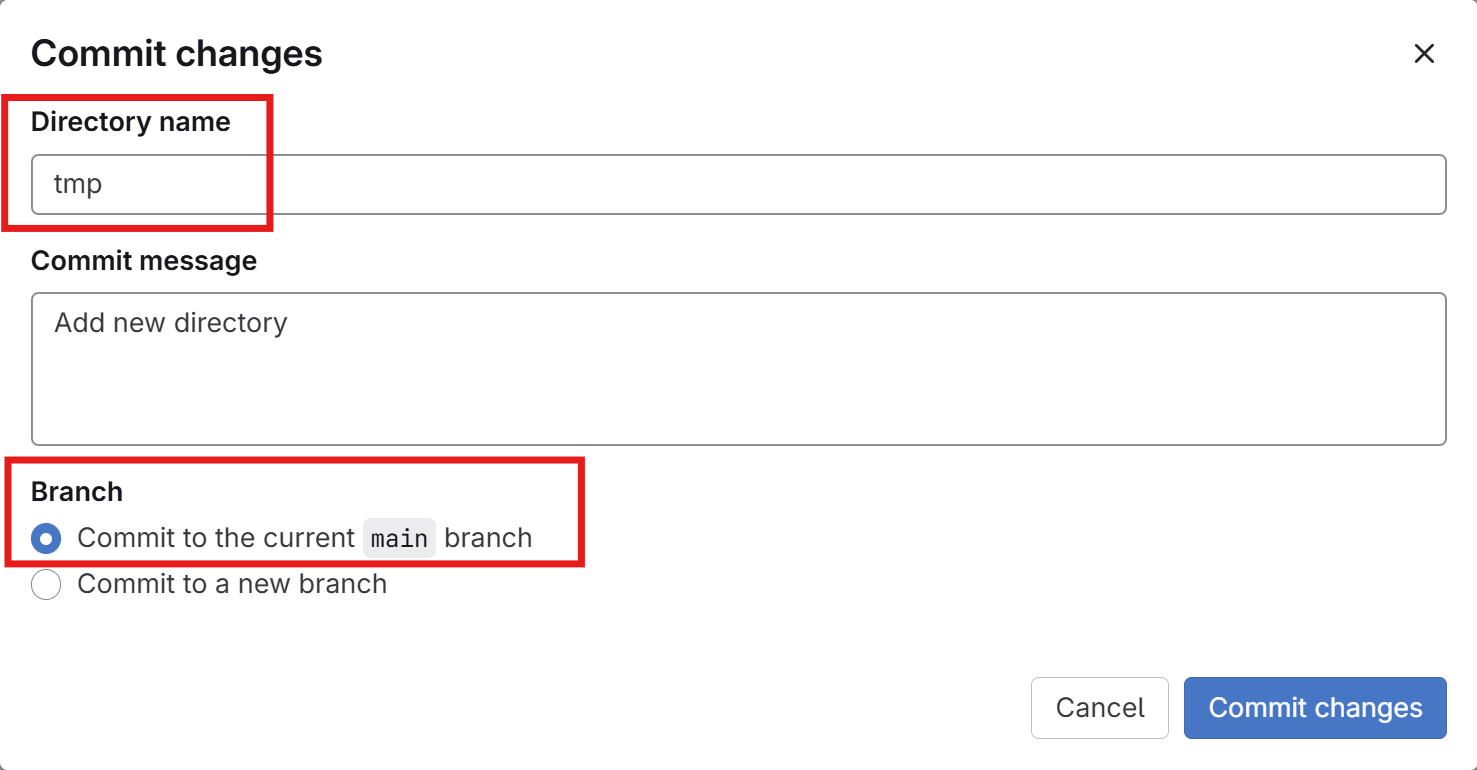
進入建立資料夾的畫面,此資料夾為存放評估結果的位置,命名需與Jenkins參數設定一致。命名後選擇commit至main branch
-
提交後即建立成功
-
- 如果您已備好模型回復檔案,將你的資料放置到專案並上傳,只需執行 eval 流程
-
請運用指令,先下載Git CMD進行操作
如果你的資料小於100MB
git clone <GIT_REPO_URL>
cd <git_repo_dir>
mkdir <version> # 建立一個<version>資料夾
cd <version>
mkdir data # 建立 data 資料夾
cd data
cp <DATA_FILES> . # 將你的資料複製到data資料夾(linux、MAC用)
copy <src_dir><DATA_FILES> <destination_dir><DATA_FILES> # 將你的資料複製到data資料夾(WINDOWS用)
git add .
git commit -m "你的提交訊息"
git push origin main # 推回你的遠端專案
如果你的資料大於100MB,請使用 git LFS 安裝頁面
Ubuntu 安裝 GIT LFS# Install Git LFS
curl -s https://packagecloud.io/install/repositories/github/git-lfs/script.deb.sh | sudo bash
sudo apt-get update
sudo apt-get install git-lfs
git lfs installWINDOWS 安裝 GIT LFS
# 1. Download the Windows Installer from the list of assets for the most recent Git LFS release
(https://github.com/git-lfs/git-lfs/releases)

# 2. Run the Windows Installer, which will be named git-lfs-windows-v*.exe

# 3. Start a command interpreter and run git lfs install
設定 LFS track
# 這裡假設要追蹤jsonl 檔案類型
git lfs track "*.jsonl"
git add .
git commit -m "設定 LFS 追蹤 .jsonl 檔案"
推回遠端專案
如前述資料小於100MB的指令,將資料複製到專案路徑後再推回遠端專案 -
本流程產生之輸出檔案皆以 git lfs 管理,無論是否自行提供資料均建議安裝
模型 API
模型評分流程總共會使用到2個語言模型:1. 欲評估的模型 GEN_MODEL 2. 裁判模型 JUDGE_MODEL。
使用步驟
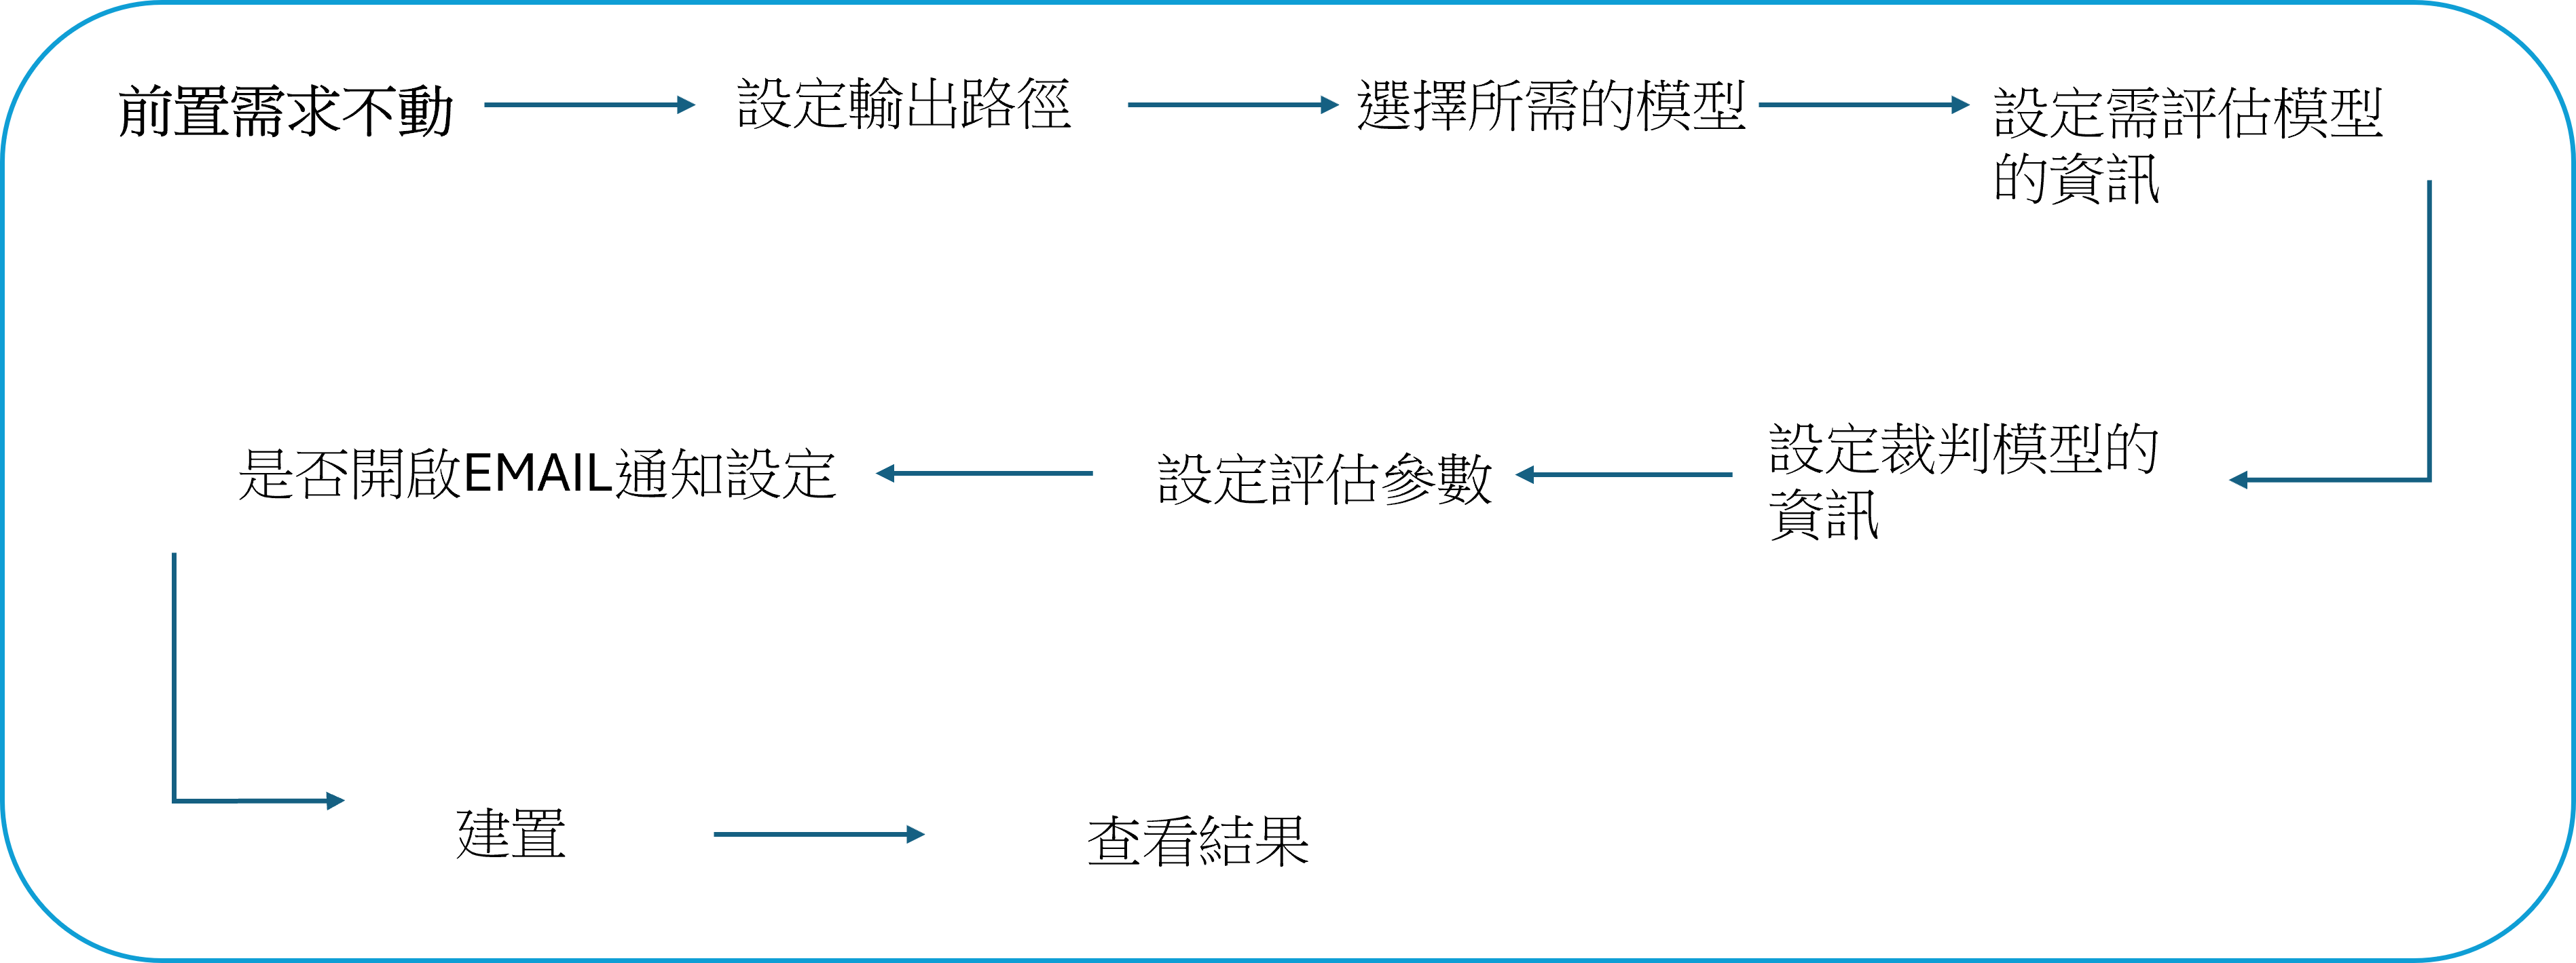
操作流程
輸出結果
評估完成後會自動上傳至指定倉庫,結構如下:
[dag_id]/                      # 完整的評估流程 modeleval; 僅生成流程 modeleval-gen; 僅評估流程 modeleval-eval
└── [時間戳]/
    ├── gen/
    |   ├── gen_<task>.jsonl  # 每個 task 的模型回覆
    |   ├── ...
    |   └── ...
    └── eval/    # 每個 task 的評估結果
        ├── eval_<task>.jsonl  # 每個 task 的評估結果 (若有重複評估,僅提供第一次評估結果)
        ├── ...
        └── overall_report.csv # 評估指標統整表
模型生成能力評估操作說明
- 登入 Portal 平台
- 平台左側選擇模型微調點選建立模型微調服務
- 至服務列表選擇所需服務,進入參數設定頁面設定參數。

(請點擊展開參數設定說明)
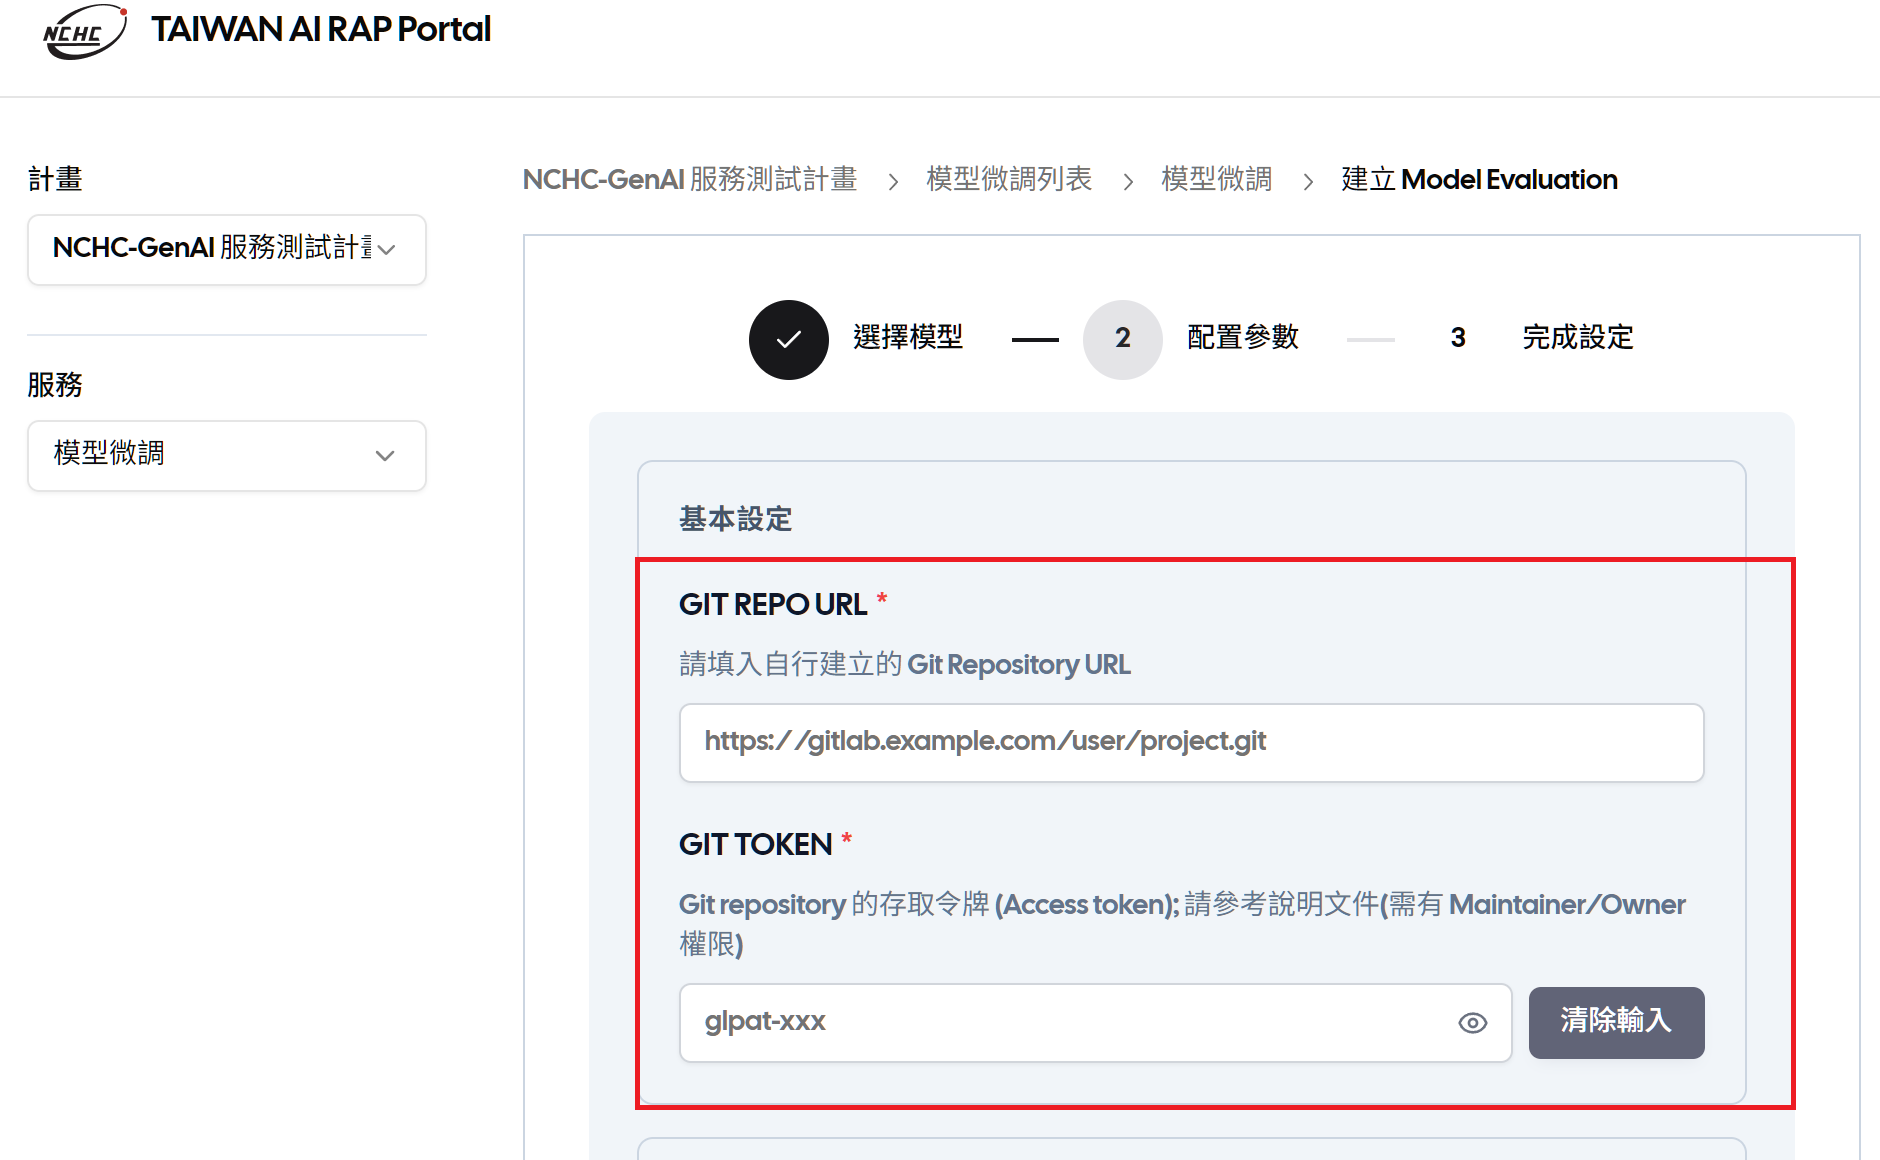
- 設定 結果輸出路徑
-
GIT REPO URL:資料集所在的 GitLab Repository URL
-
GIT TOKEN:該 Repository 的存取令牌
- 設定被測試的模型
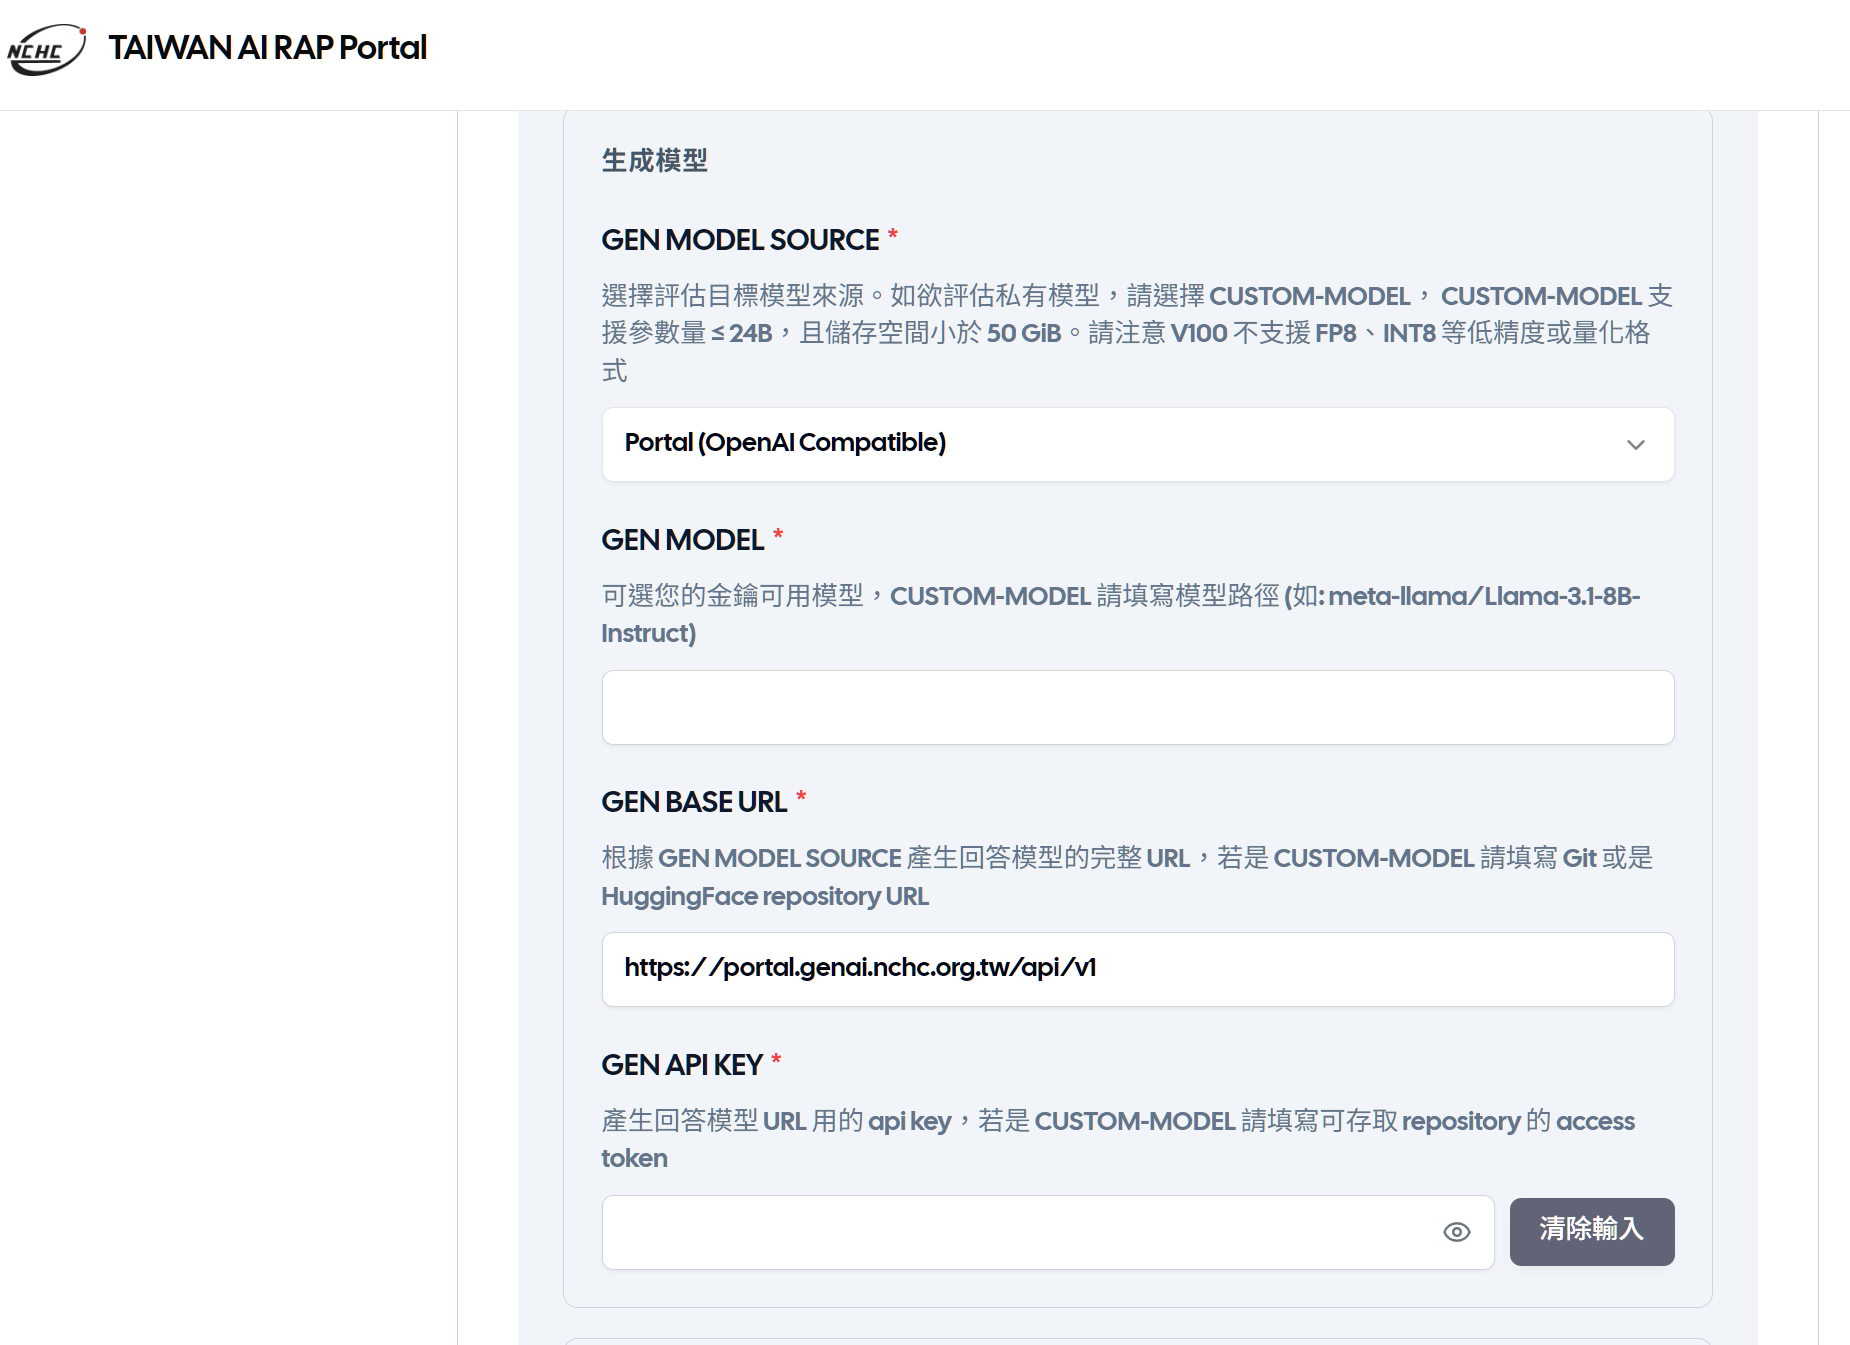
- GEN MODEL SOURCE (被測模型)
- GEN MODEL SOURCE:可選擇
PORTAL(OPENAI-COMPATIBLE)-適用於RAP平台的模型、OPENAI、或CUSTOM MODEL - GEN MODEL:輸入要測試的模型名稱,可填入您的金鑰可用模型
- GEN BASE URL
- GEN API KEY:輸入您的 API 服務金鑰
- GEN MODEL SOURCE:可選擇
- 設定裁判的模型
- JUDGE MODEL SOURCE (裁判模型)
-
JUDGE MODEL SOURCE:可選擇
PORTAL(OPENAI-COMPATIBLE)-適用於RAP平台的模型、OPENAI -
JUDGE MODEL:輸入用來評估的模型名稱,建議使用功能較強模型
-
JUDGE MODEL URL
-
JUDGE MODEL KEY:輸入您的 API 服務金鑰

-
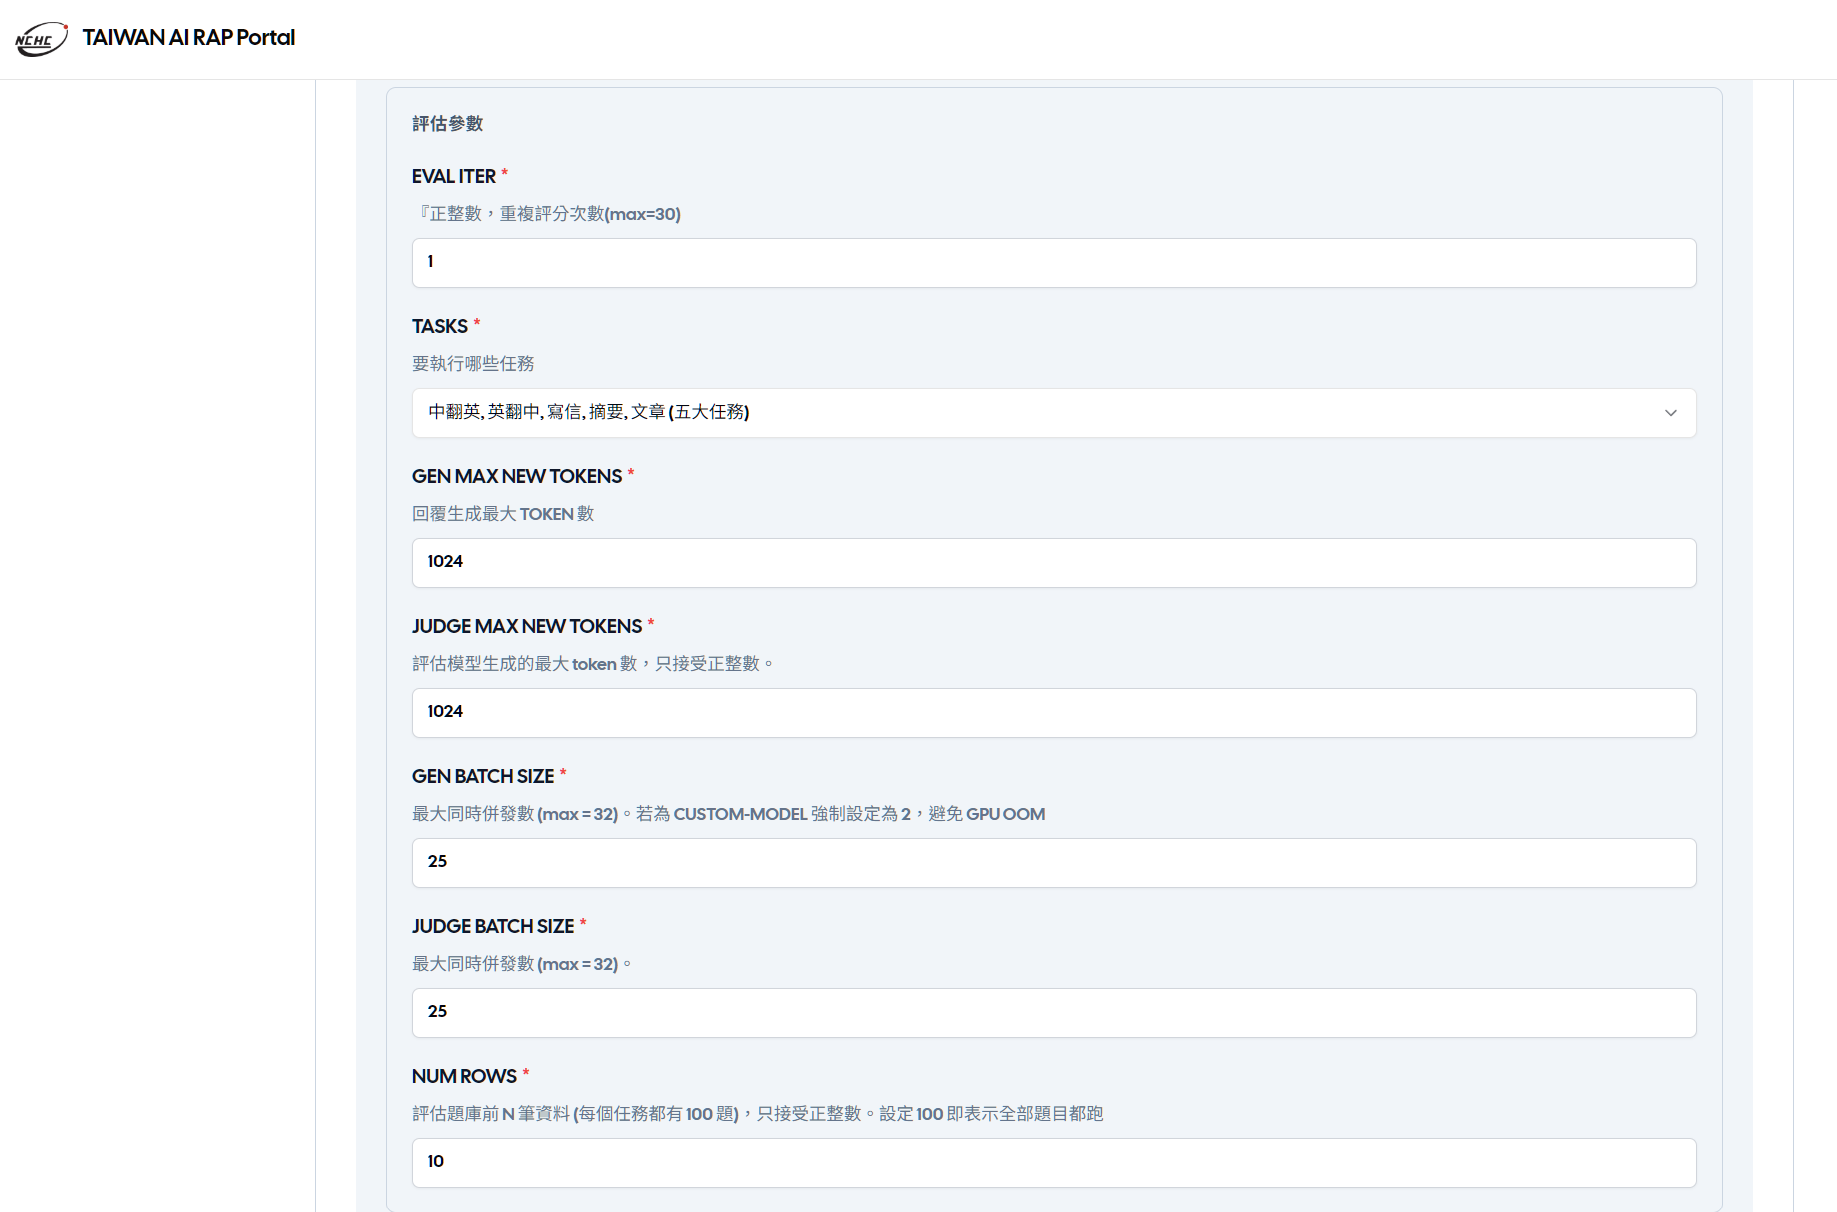
- 設定評估參數
- 設定 EVALITER
- 選擇重複評分次數(最多可設到 30)
- 次數越多 → 結果越可靠,但所需時間也會更長
- 選擇 評估任務類型 (TASKS)
- 五大任務(英翻中、論文、書信、摘要、中翻英)
- 國科會四大任務(公文、新聞稿、民眾陳情、模擬問答)
- 其他參數(
-
MAX_NEW_TOKENS,指定評估模型和GEN MODEL,每次生成的最大token數
-
NUM_ROWS,評估幾筆資料
-
若無特殊需求,不須特別更動設定
-
-
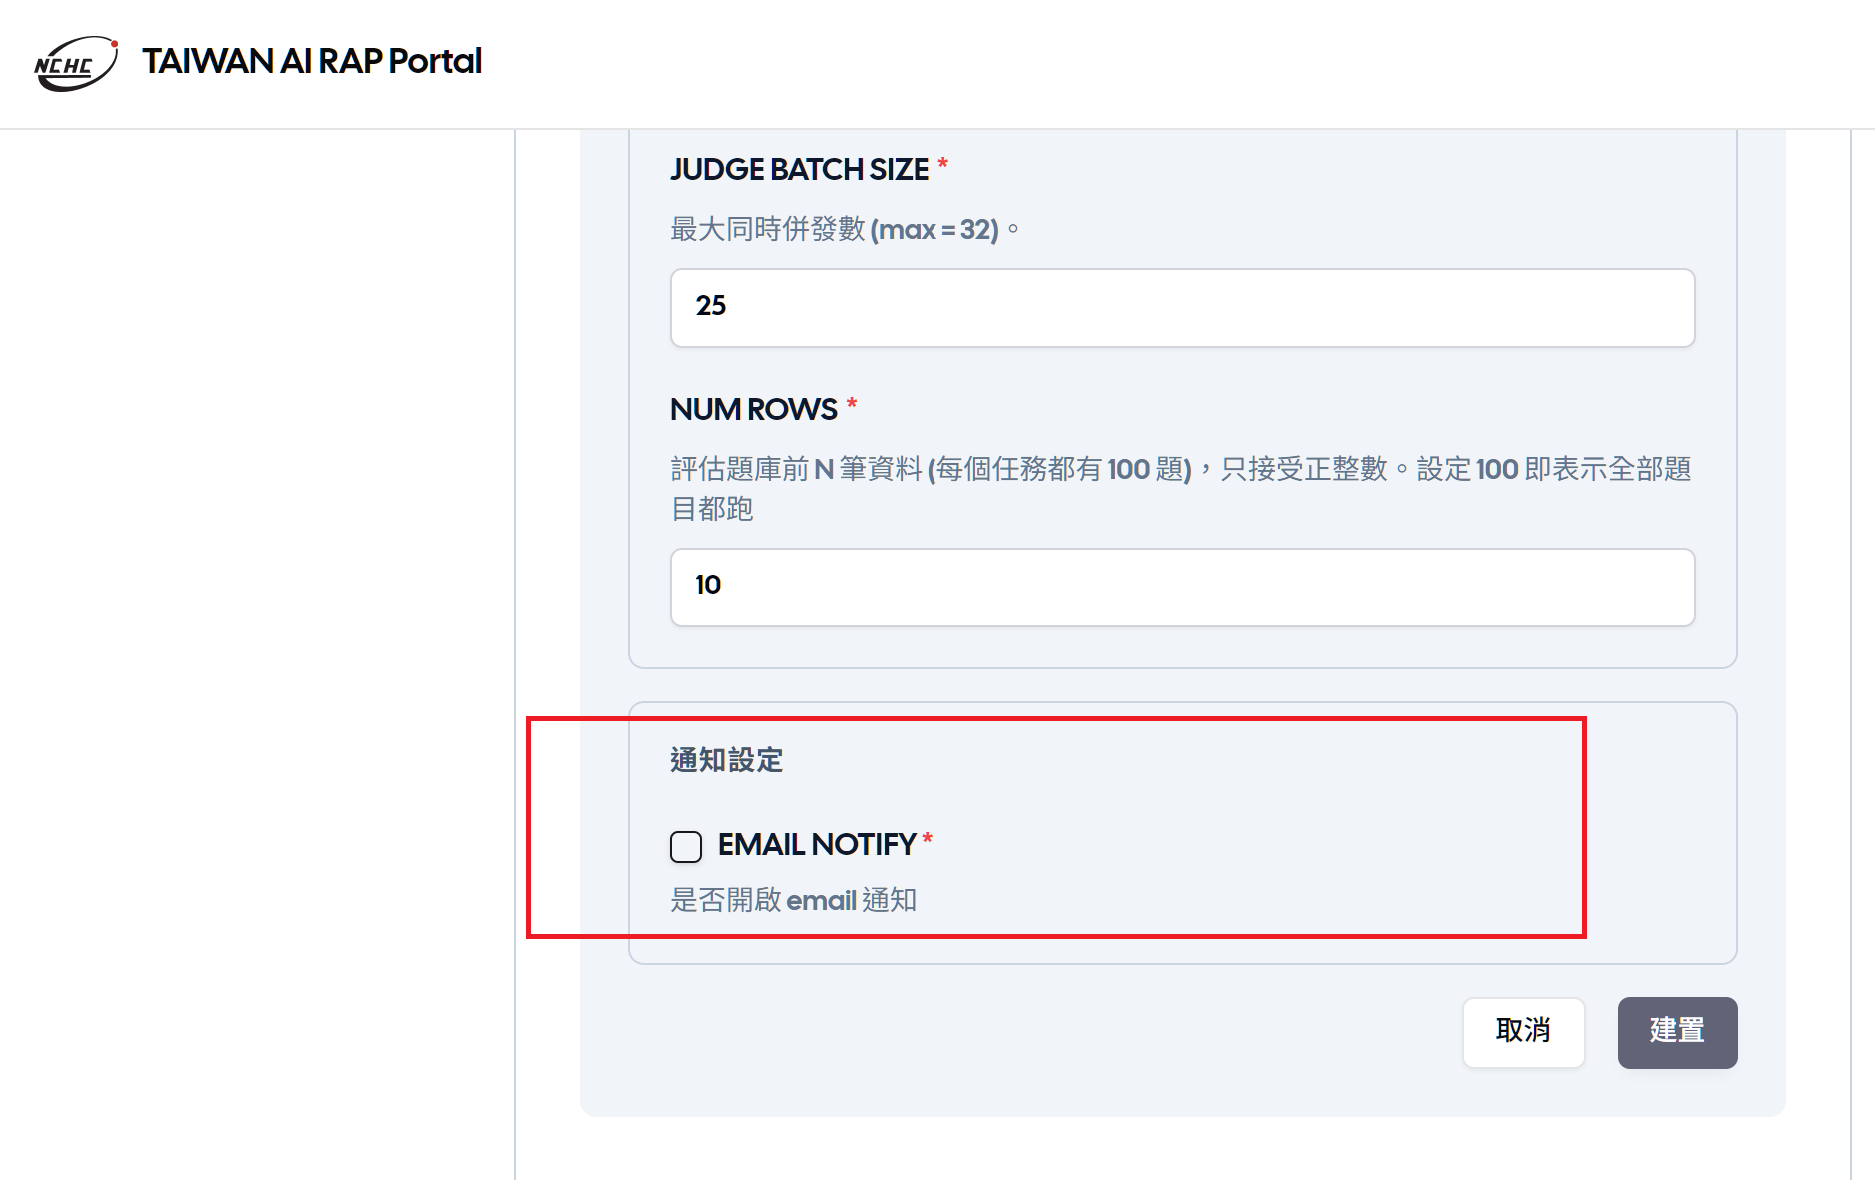
是否開啟EMAIL通知設定:如果開啟,請輸入電子郵件地址。
- 確認無誤後,點擊 「建置」 按鈕
- 查看結果
- 完成執行後,會呼叫被測模型 → 使用裁判模型評分 → 彙整結果
- 完成後,結果會自動 push 至指定的 Git Repository
注意事項
- 請注意,上傳過程中請勿對目標Repository進行任何修改,任何修改都可能導致上傳任務失敗。
- Repository 建議設為 Private,確保資料安全。
- Access Token 需同時具備 讀取與寫入權限,否則 Airflow DAG 無法成功執行。
- JUDGE MODEL 建議使用能力較佳且指令遵循能力較高之模型,如
overall_report.csv內的 na rate 過高,表示該模型不適合做為 JUDGE MODEL 使用 - eval_iter 運作邏輯為每題 JUDGE MODEL 評估數次,去除離群值後取平均作為該題的得分,因此若需要充分利用此功能,請 eval_iter 設定至少大於 4。然而,數字越大,評估耗時越久,JUDGE MODEL 輸出 TOKEN 總量也會增加,請自行考量成本。
- 使用具備推理能力的模型時,請注意 max_new_tokens 設定,避免輸出 token 數於思考過程使用完畢,而未輸出回復。
- 如使用者自行上傳模型回復檔案,只進行評估流程 (
evl),data_path目錄下的檔案名稱務必遵從gen_<task>.jsonl,如檔名不符合命名格式,則無法進行評估。 - 本流程目前最多支援 2 張 V100 GPU,CUSTOM-MODEL 建議勿超過 24B (dtype=FP16),儲存空間請勿超出 50 GiB。此外請注意 dtype,V100 不支援 FP8 等低精度量化格式。
- CUSTOM-MODEL 必須為有聊天能力或 Instruction-Following 能力的模型 (必須能支援 chat_completion )
常見問題
-
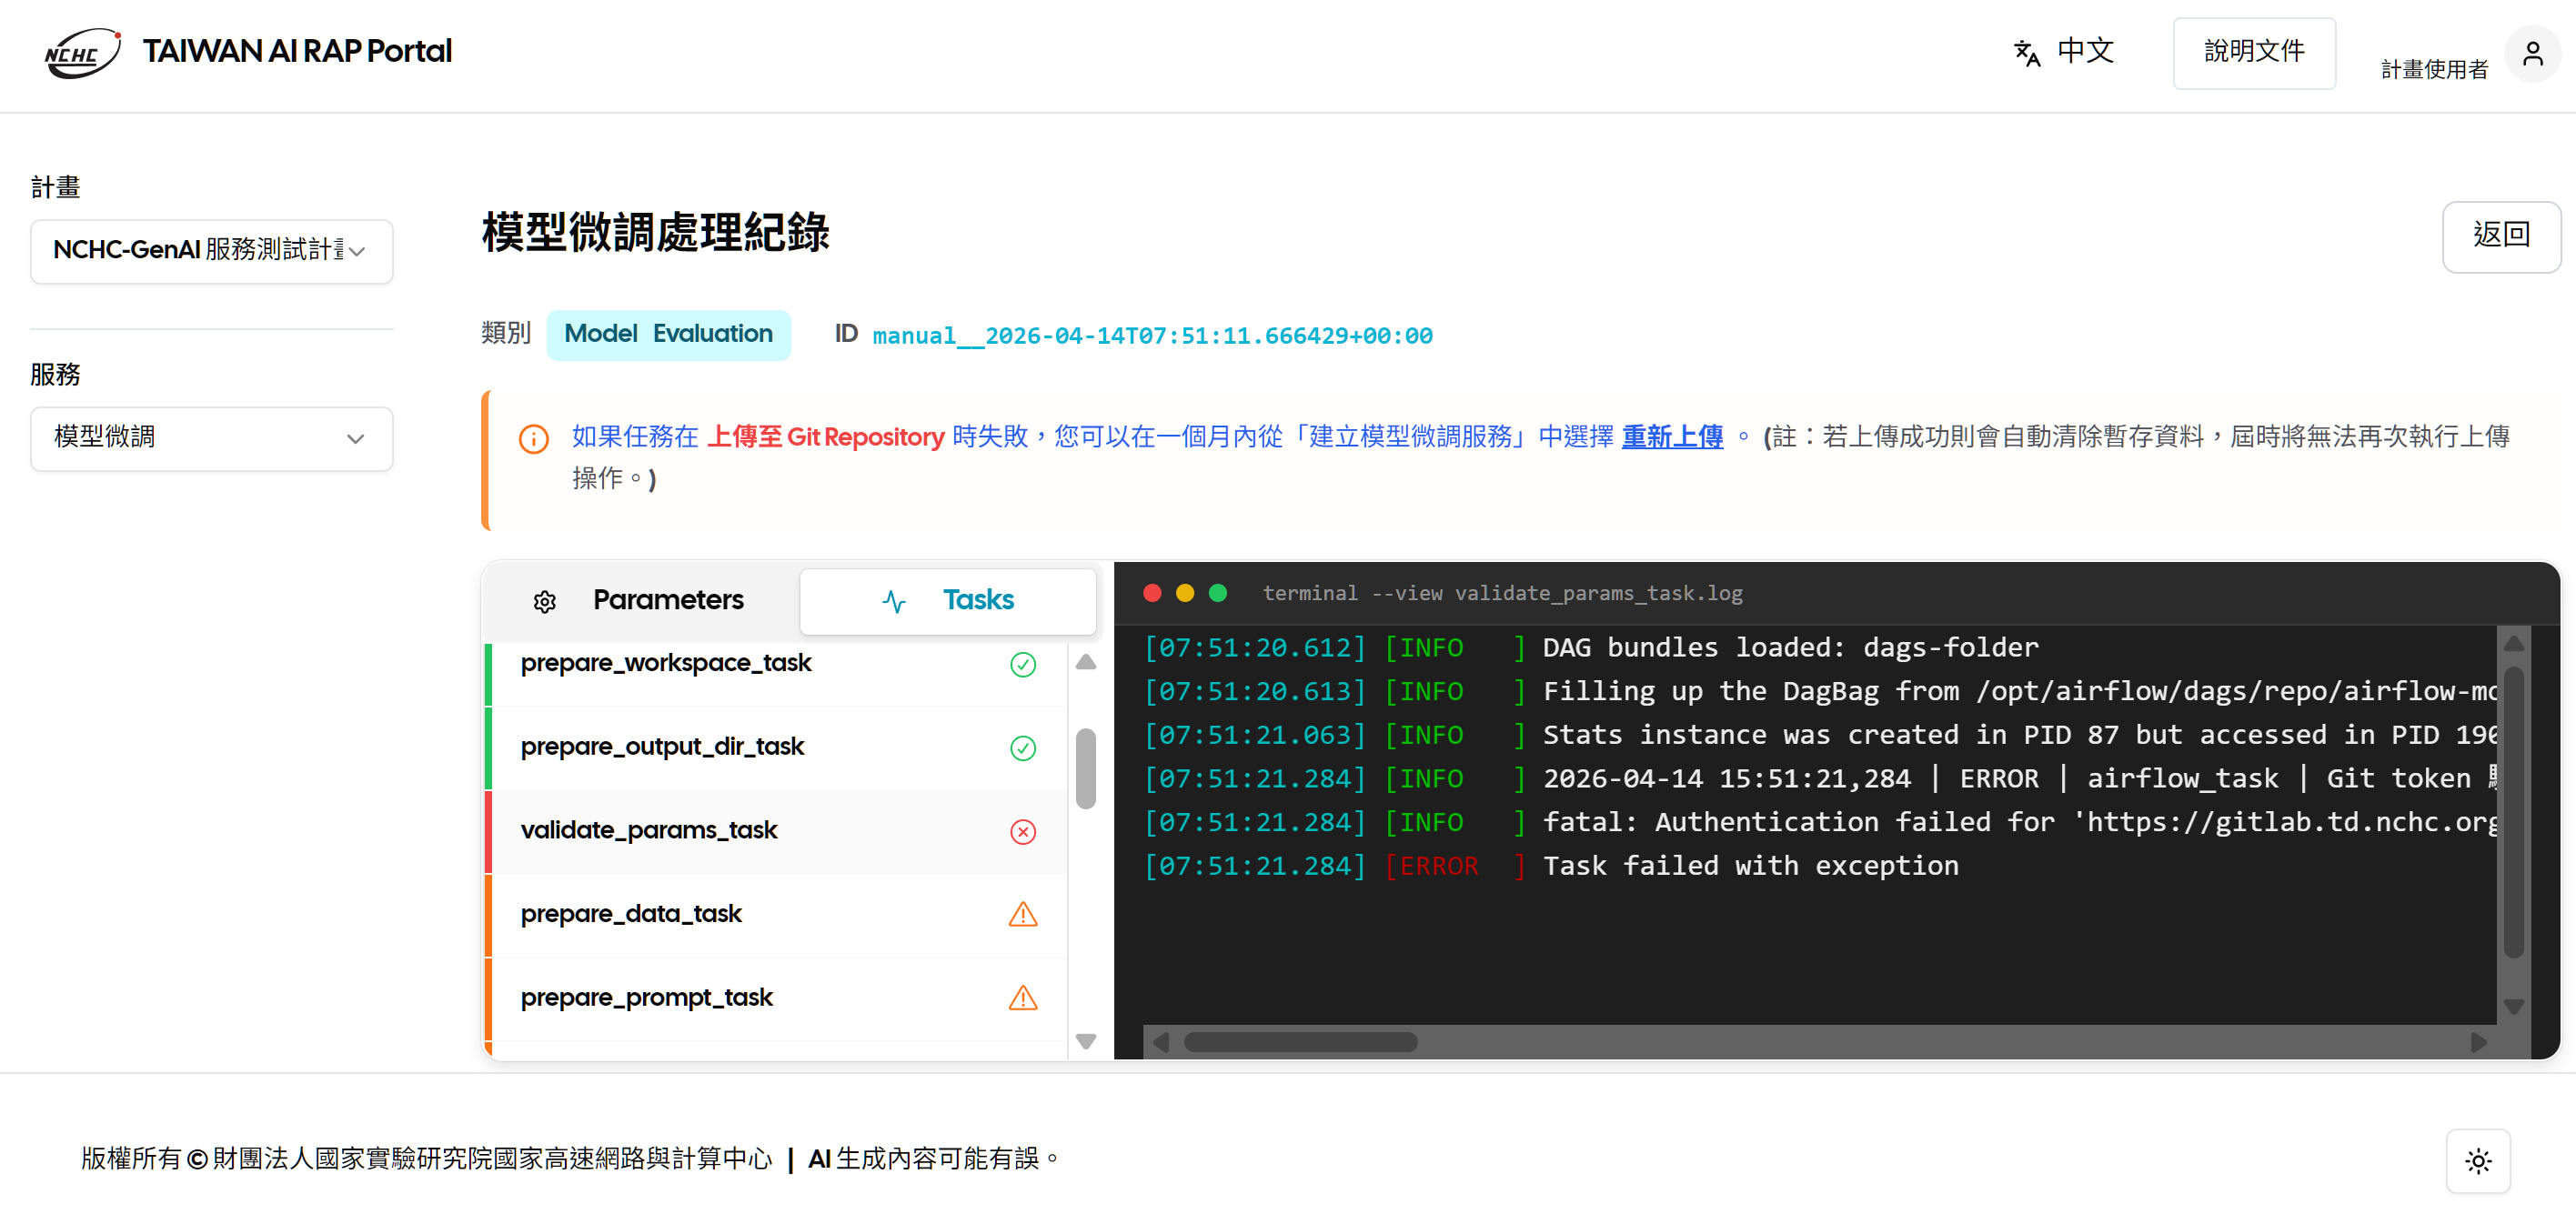
Q: 如何查詢各task處理紀錄的log?
-
A: 請至模型微調首頁的模型微調列表點擊各task的資訊查看log。
- 若看到其中的任務發生 error,且 mark_failed_task 也顯示 error,代表整次的 dag 失敗,可以先確認失敗的任務是什麼內容;如果是在最後上傳資料時失敗可能是網路穩定性問題,可以在建立模型微調服務中選擇重新上傳資料;其他任務失敗需要點選錯誤任務查看錯誤訊息進行排查。
-
Q: 如何取得 git_token?
-
A: 請至 GitLab/Github → User Settings → Access Tokens 建立含 read repository / write repository 權限的權杖。
-
Q:
overall_report.csv如何解讀 -
A: 四大任務會有兩個指標,MatchPoint 代表題文匹配度,TextFormat 代表文本格式,兩項分別評分;五大任務近有一個指標 Score。na rate 代表 JUDGE MODEL 評估失敗的比率
-
Q:
gen_<task>.jsonl是甚麼 -
A: 模型生成回復的結果。
qid為題目編號,評估時會以qid比對題庫;model為生成回復的模型;prompt為題庫的題目;resp為模型的回復 -
Q:
eval_<task>.jsonl是甚麼 -
A: 模型評估的結果。
qid為題目編號;model為評估模型;prompt為題庫的題目;resp為模型的回復;<metrics>為四大任務或五大任務各自的分數指標;Judgement為評估模型的完整回復 -
Q: 我的模型是 14B 模型,為什麼在生成回復時會錯誤?
-
A: 請檢查您的模型 dtype,V100 不支援 FP8、INT8 等低精度量化格式。如果 dtype 為 BF16,則理論上會占用 2 倍以上的 GPU Memory,即類似 28B 的 FP16 模型,請確認 log 是否為 GPU Memoery 不足。
-
Q: CUSTOM-MODEL 生成回復跑好久
-
A: 為避免負載過大 OOM,API 併發數限制為 2,因此推論速度較慢。請調整 NUM_ROWS 減少題數,或者自行使用較高階的 GPU 跑 API server。