LLM 訓練服務操作步驟說明
歡迎點擊右側連結至新分頁觀看。 watch video
概述
本專案流程提供模型 SFT (Supervised Fine-Tuning) 訓練服務、模型強化學習 (Reinforcement learning, RL) 訓練服務、模型剪枝 (Forgetting-Aware Pruning Metric)服務以及模型直接偏好最佳化 (Direct Preference Optimization, DPO)服務 。
- 模型 SFT (Supervised Fine-Tuning) 訓練服務
-
使用者可自行選擇基礎模型 (base model) 及訓練方式 (全參數或LoRA),並且自行提供訓練資料,進行特定任務/能力微調訓練。
-
執行位置:
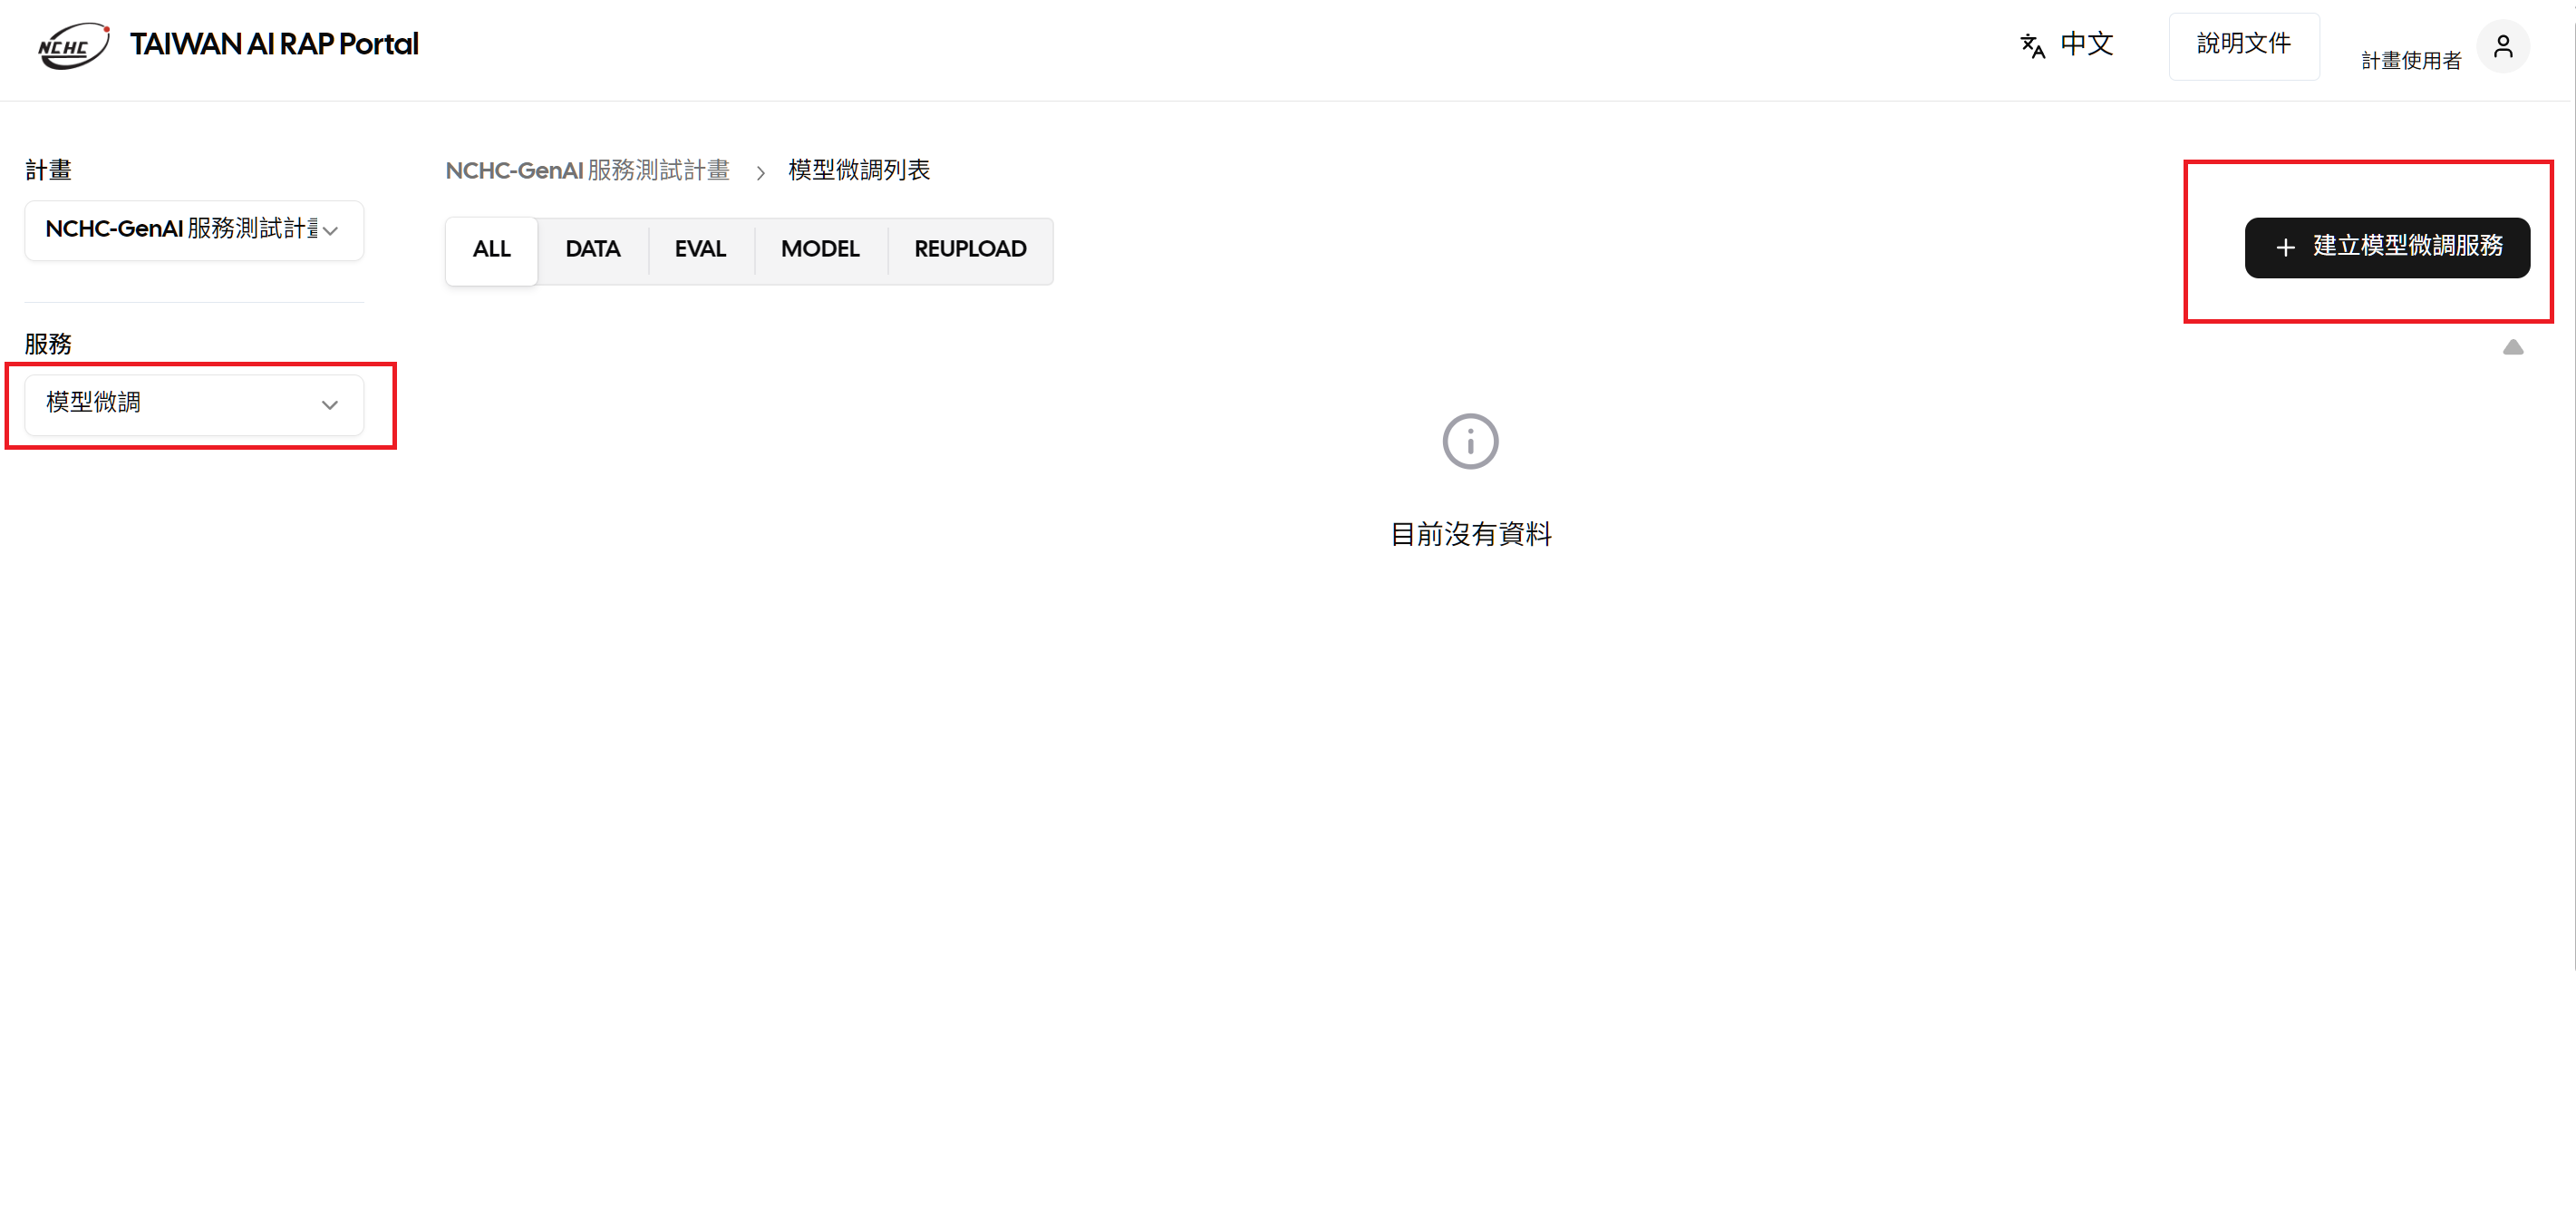

- 請選擇 Supervised Fine-Tuning
- 模型強化學習 (Reinforcement learning, RL) 訓練服務
-
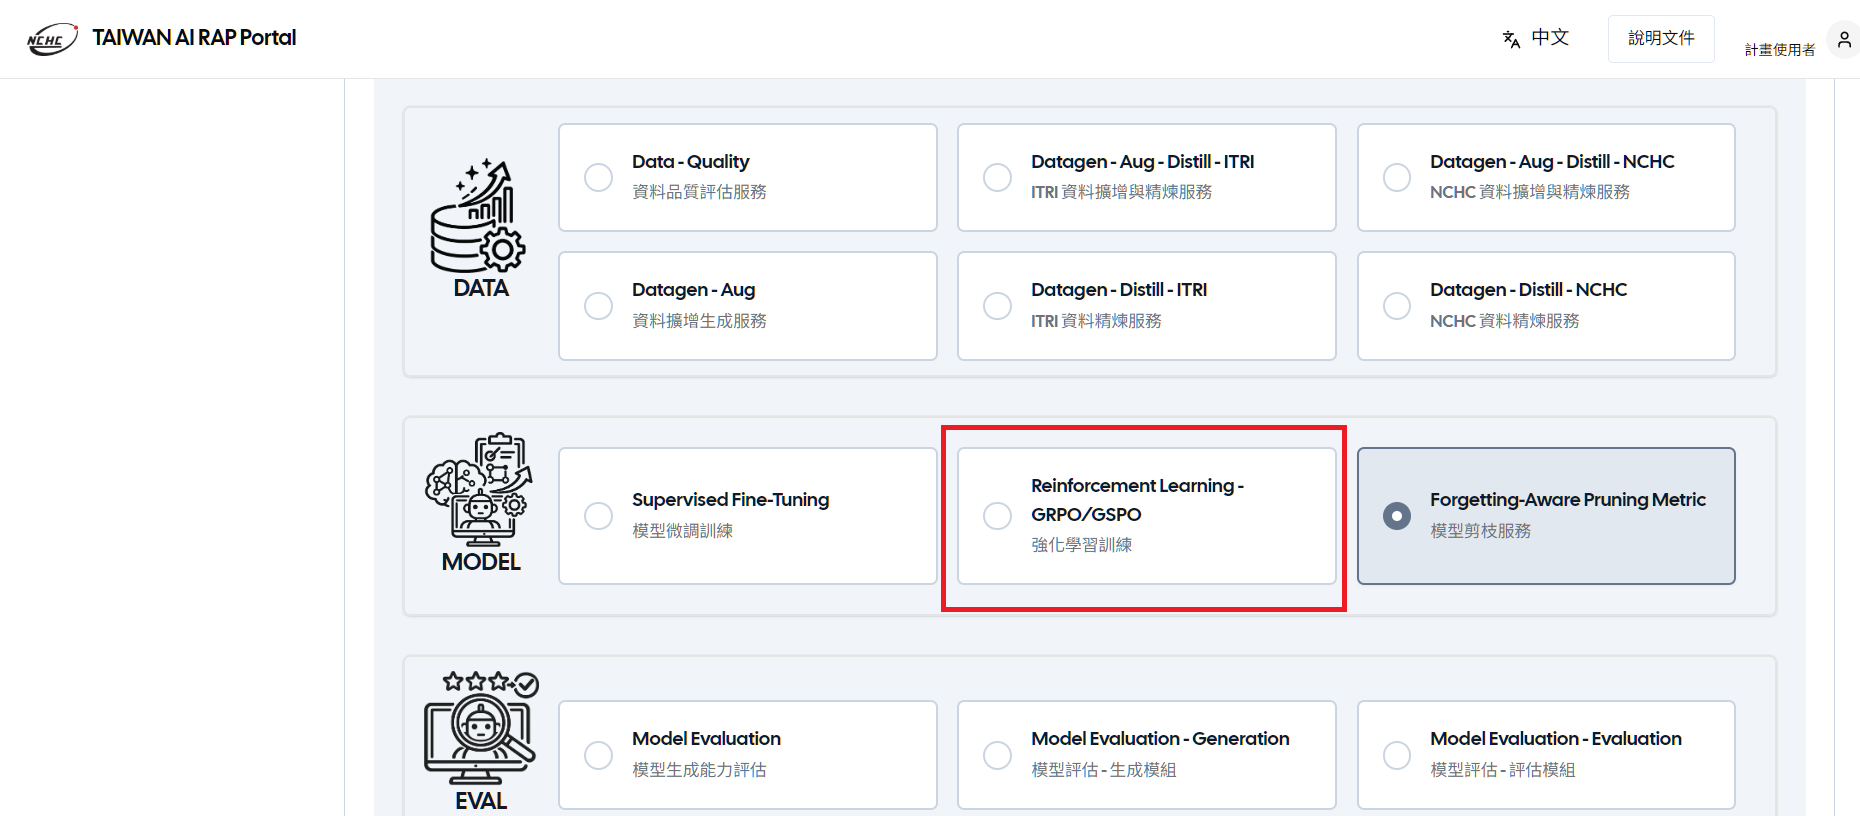
使用者可自行選擇基礎模型 (base model)、 RL 方法 (GRPO/GSPO) 及訓練方式 (全參數或LoRA),並且自行提供訓練資料,進行強化學習訓練。
-
執行位置:
- 請選擇 Reinforcement Learning - GRPO/GSPO
- 模型剪枝(Forgetting-Aware Pruning Metric) 服務
-
使用者可自行設定基礎模型 (base model) 及微調後模型 (FT model),設定 prune ratio 剪枝比例進行模型剪枝,緩解模型災難性遺忘問題。
-
執行位置:
- 請選擇 Forgetting-Aware Pruning Metric
- 模型直接偏好最佳化(Direct Preference Optimization, DPO) 訓練服務
-
使用者可自行選擇基礎模型 (base model) 及訓練方式 (全參數或LoRA),並且自行提供訓練資料,進行直接偏好最佳化訓練。
-
執行位置:
- 請選擇 Direct Preference Optimization
前置需求
GitLab 專案 (Repository)
使用者將藉由 Gitlab Repository 提供微調訓練資料,請按照以下步驟完成前置準備:
- 請先自行建立專案
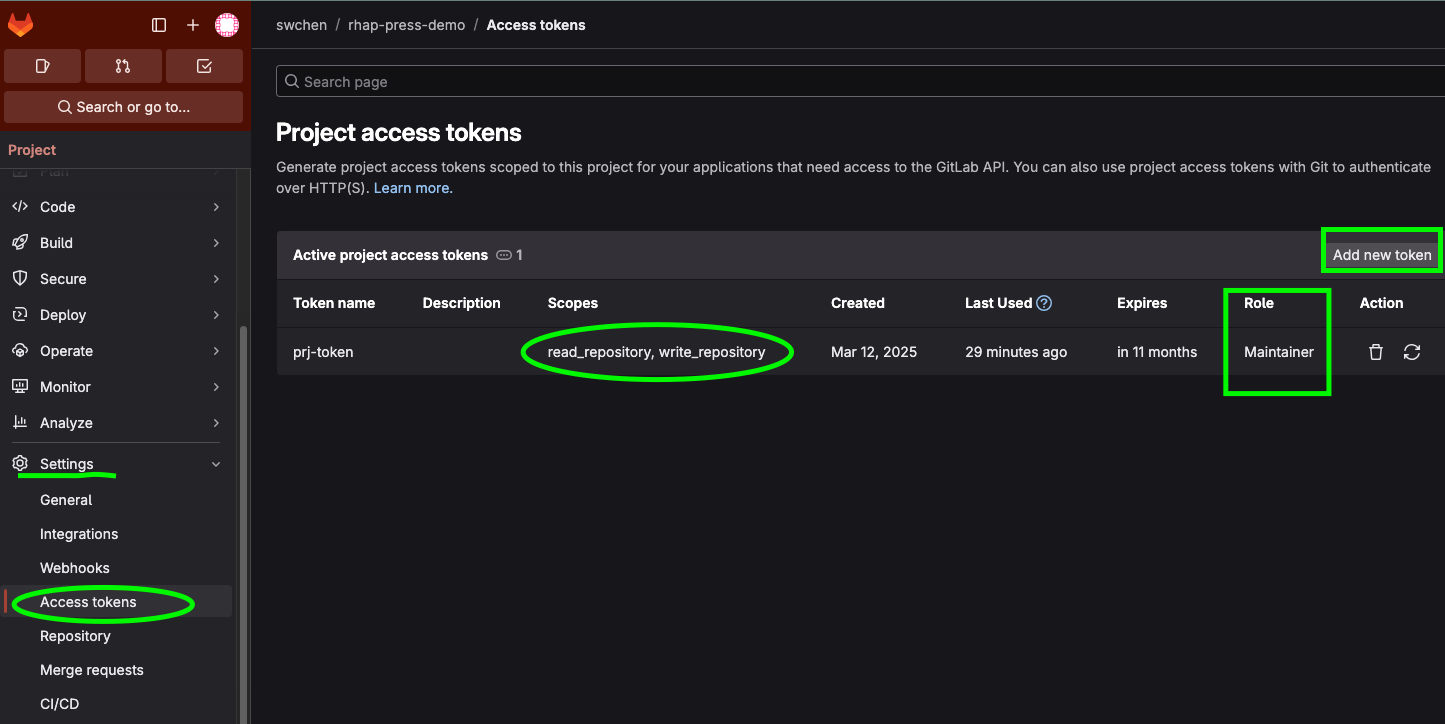
- 申請存取令牌(Access tokens)
(1) 申請方式:進入欲使用的專案 -> Settings -> Access tokens -> Add new token
(2) Scopes 選擇 read_repository, write_repository
(3) Role 選擇 Maintainer 或 Owner
(4) 存取令牌申請完成後,請務必存放在安全的地方,離開頁面後便無法再取得
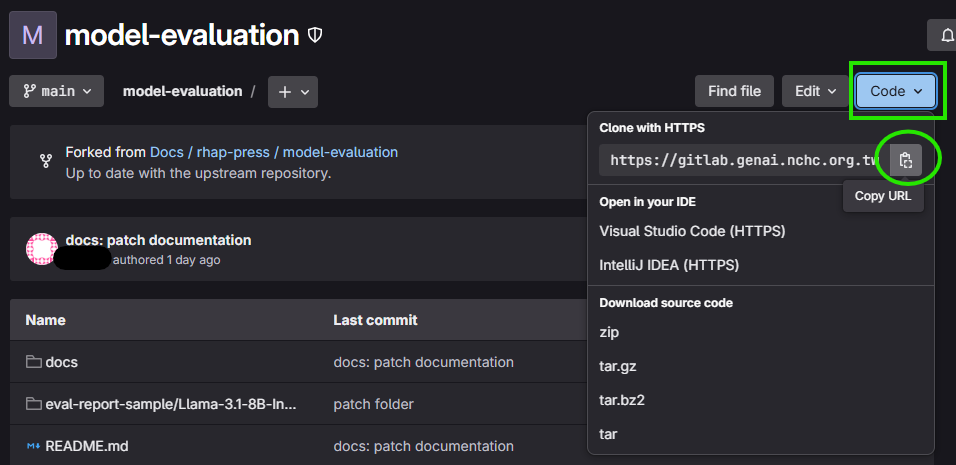
- 取得專案 URL
GIT_REPO_URL
- 將你的資料放置到專案並上傳 (以下步驟模型剪枝服務無須操作)
-
方法一(運用指令,請先下載Git CMD進行操作)
如果你的資料小於100MB
git clone <GIT_REPO_URL>
cd <git_repo_dir>
cp <DATA_FILES> . # 將你的資料複製到專案路徑(linux、MAC用)
copy <src_dir><DATA_FILES> <destination_dir><DATA_FILES> # 將你的資料複製到專案路徑(WINDOWS用)
git add .
git commit -m "你的提交訊息"
git push origin main # 推回你的遠端專案
如果你的資料大於100MB,請使用 git LFS 安裝頁面
Ubuntu 安裝 GIT LFS# Install Git LFS
curl -s https://packagecloud.io/install/repositories/github/git-lfs/script.deb.sh | sudo bash
sudo apt-get update
sudo apt-get install git-lfs
git lfs installWINDOWS 安裝 GIT LFS
# 1. Download the Windows Installer from the list of assets for the most recent Git LFS release
(https://github.com/git-lfs/git-lfs/releases)

# 2. Run the Windows Installer, which will be named git-lfs-windows-v*.exe

# 3. Start a command interpreter and run git lfs install
設定 LFS track
# 這裡假設要追蹤jsonl 檔案類型
git lfs track "*.jsonl"
git add .
git commit -m "設定 LFS 追蹤 .jsonl 檔案"
推回遠端專案
如前述資料小於100MB的指令,將資料複製到專案路徑後再推回遠端專案 -
方法二(運用GUI)
-
至專案首頁點擊 "+" 按鈕並依序選擇"New directory"及"Upload file"
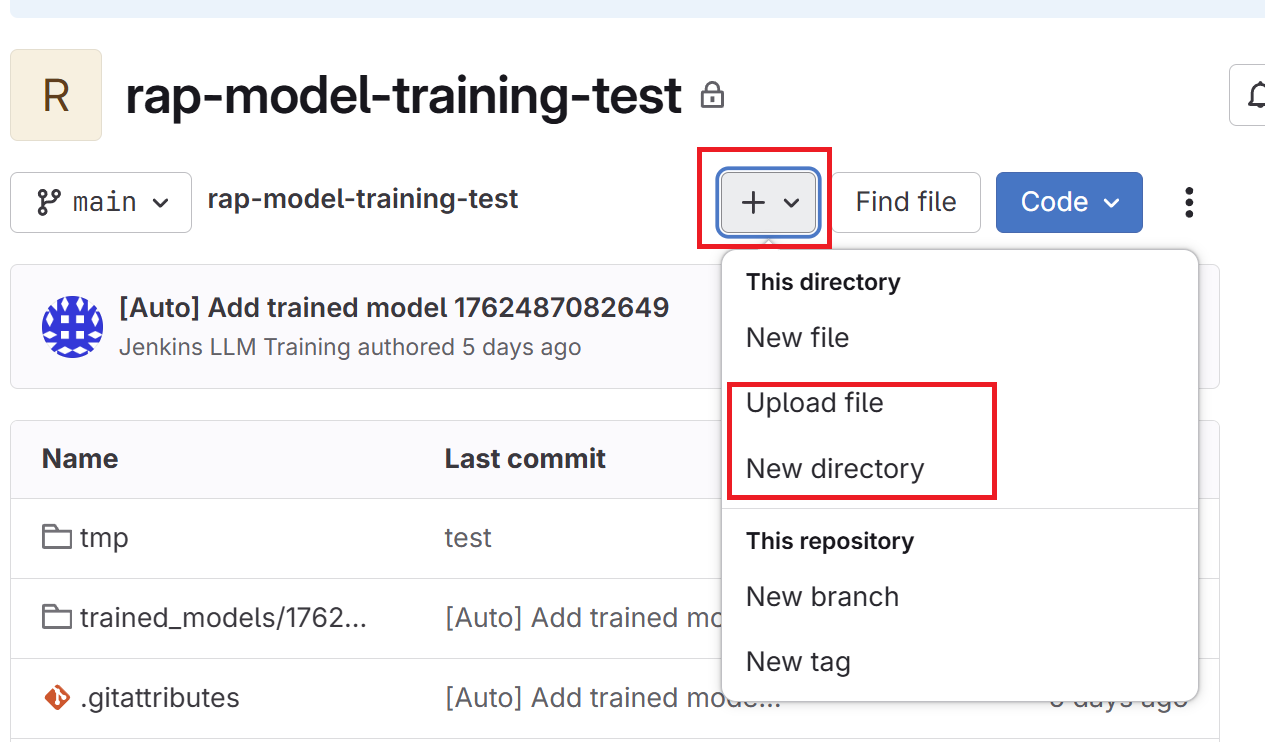
-
按指示操作將資料上傳到專案上所建立的路徑位置,此位置為訓練資料檔案路徑,命名需與參數設定一致。
-
提交後即建立成功
-
使用步驟
操作流程
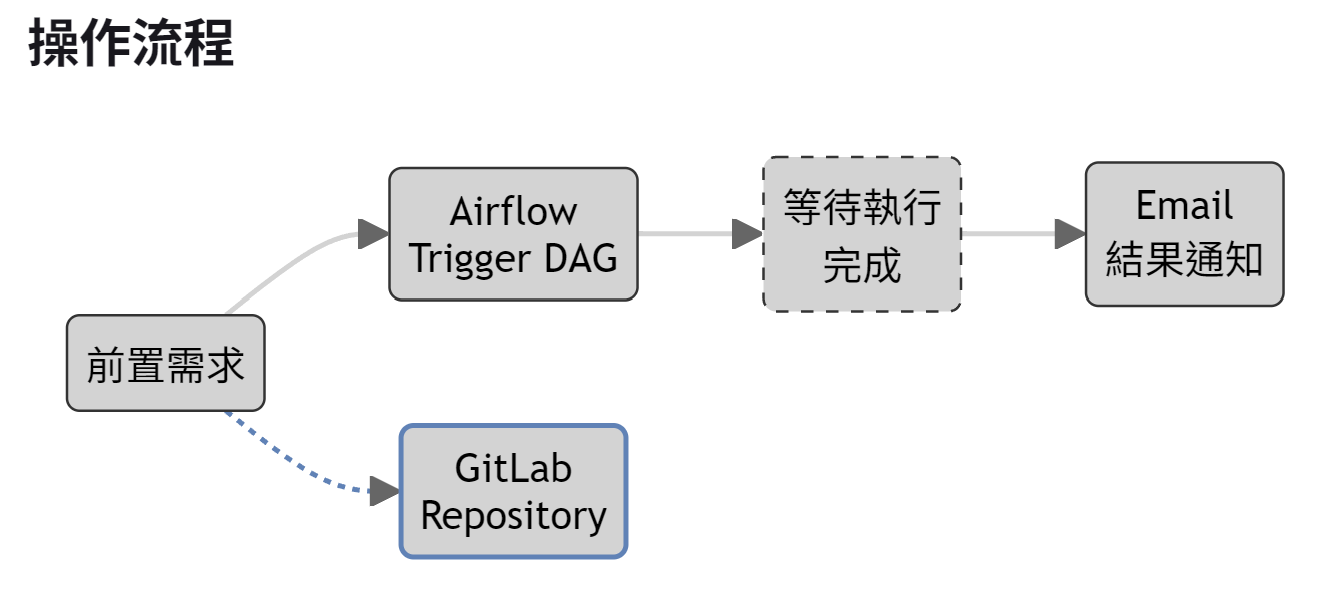
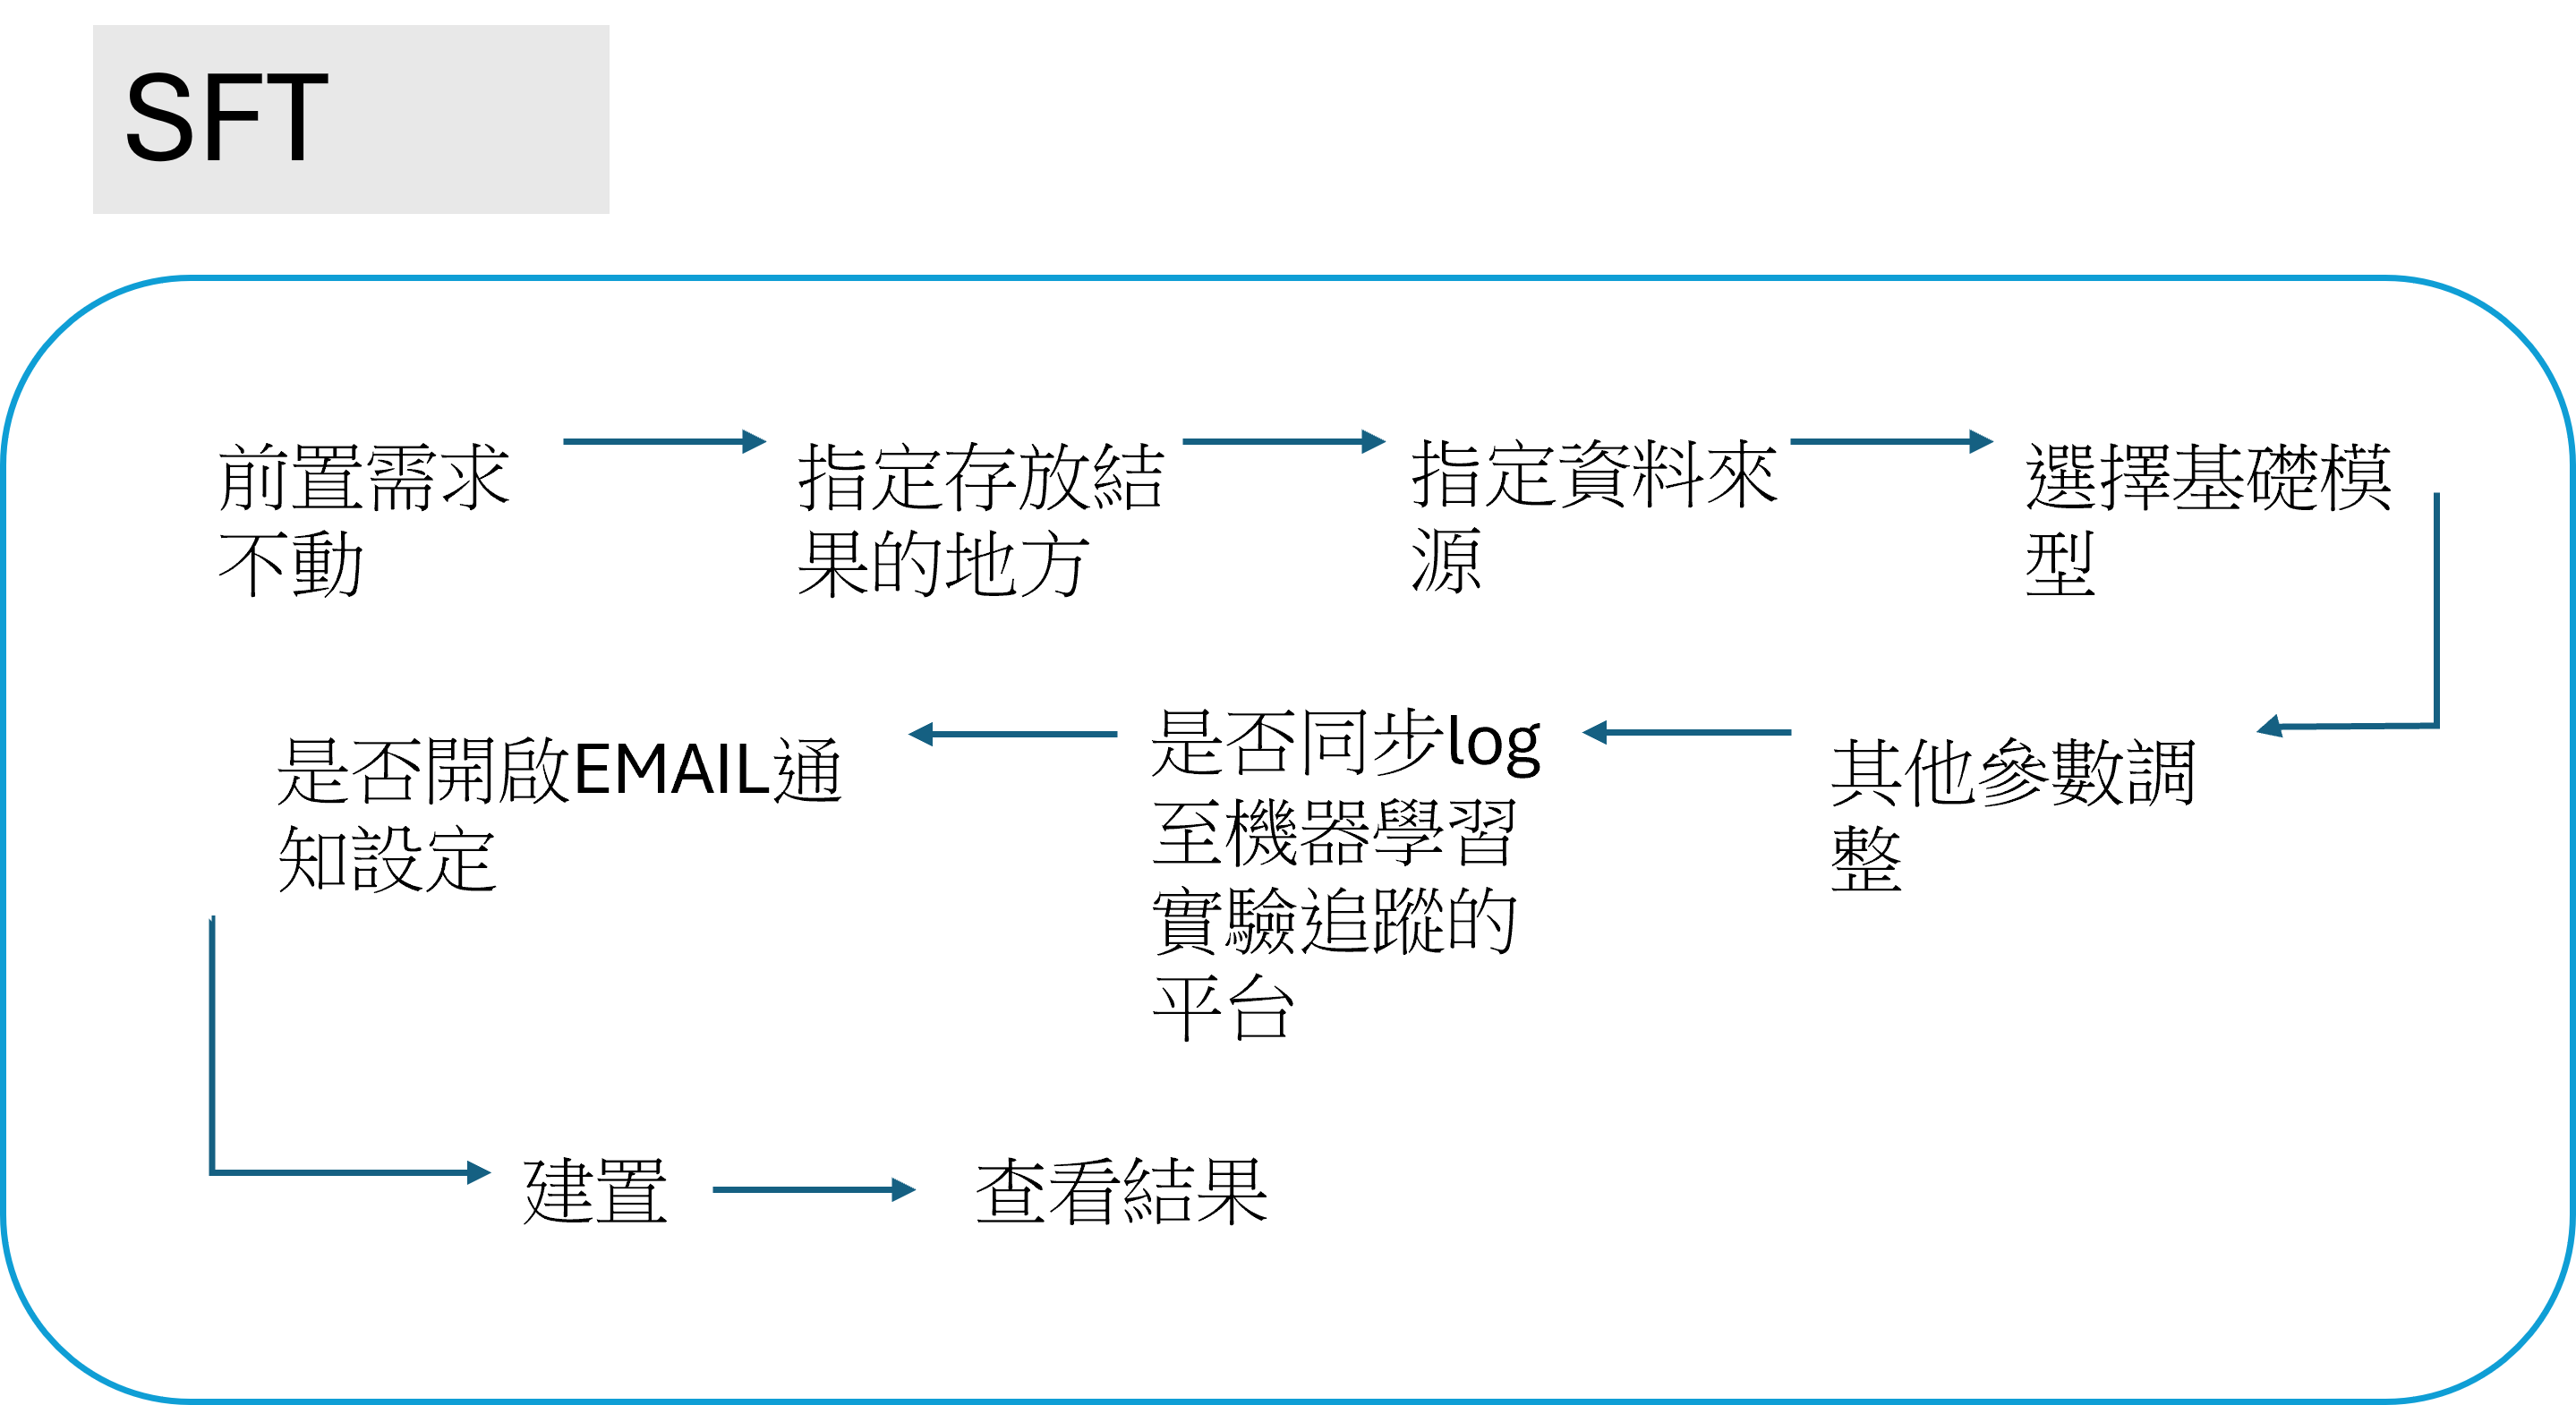
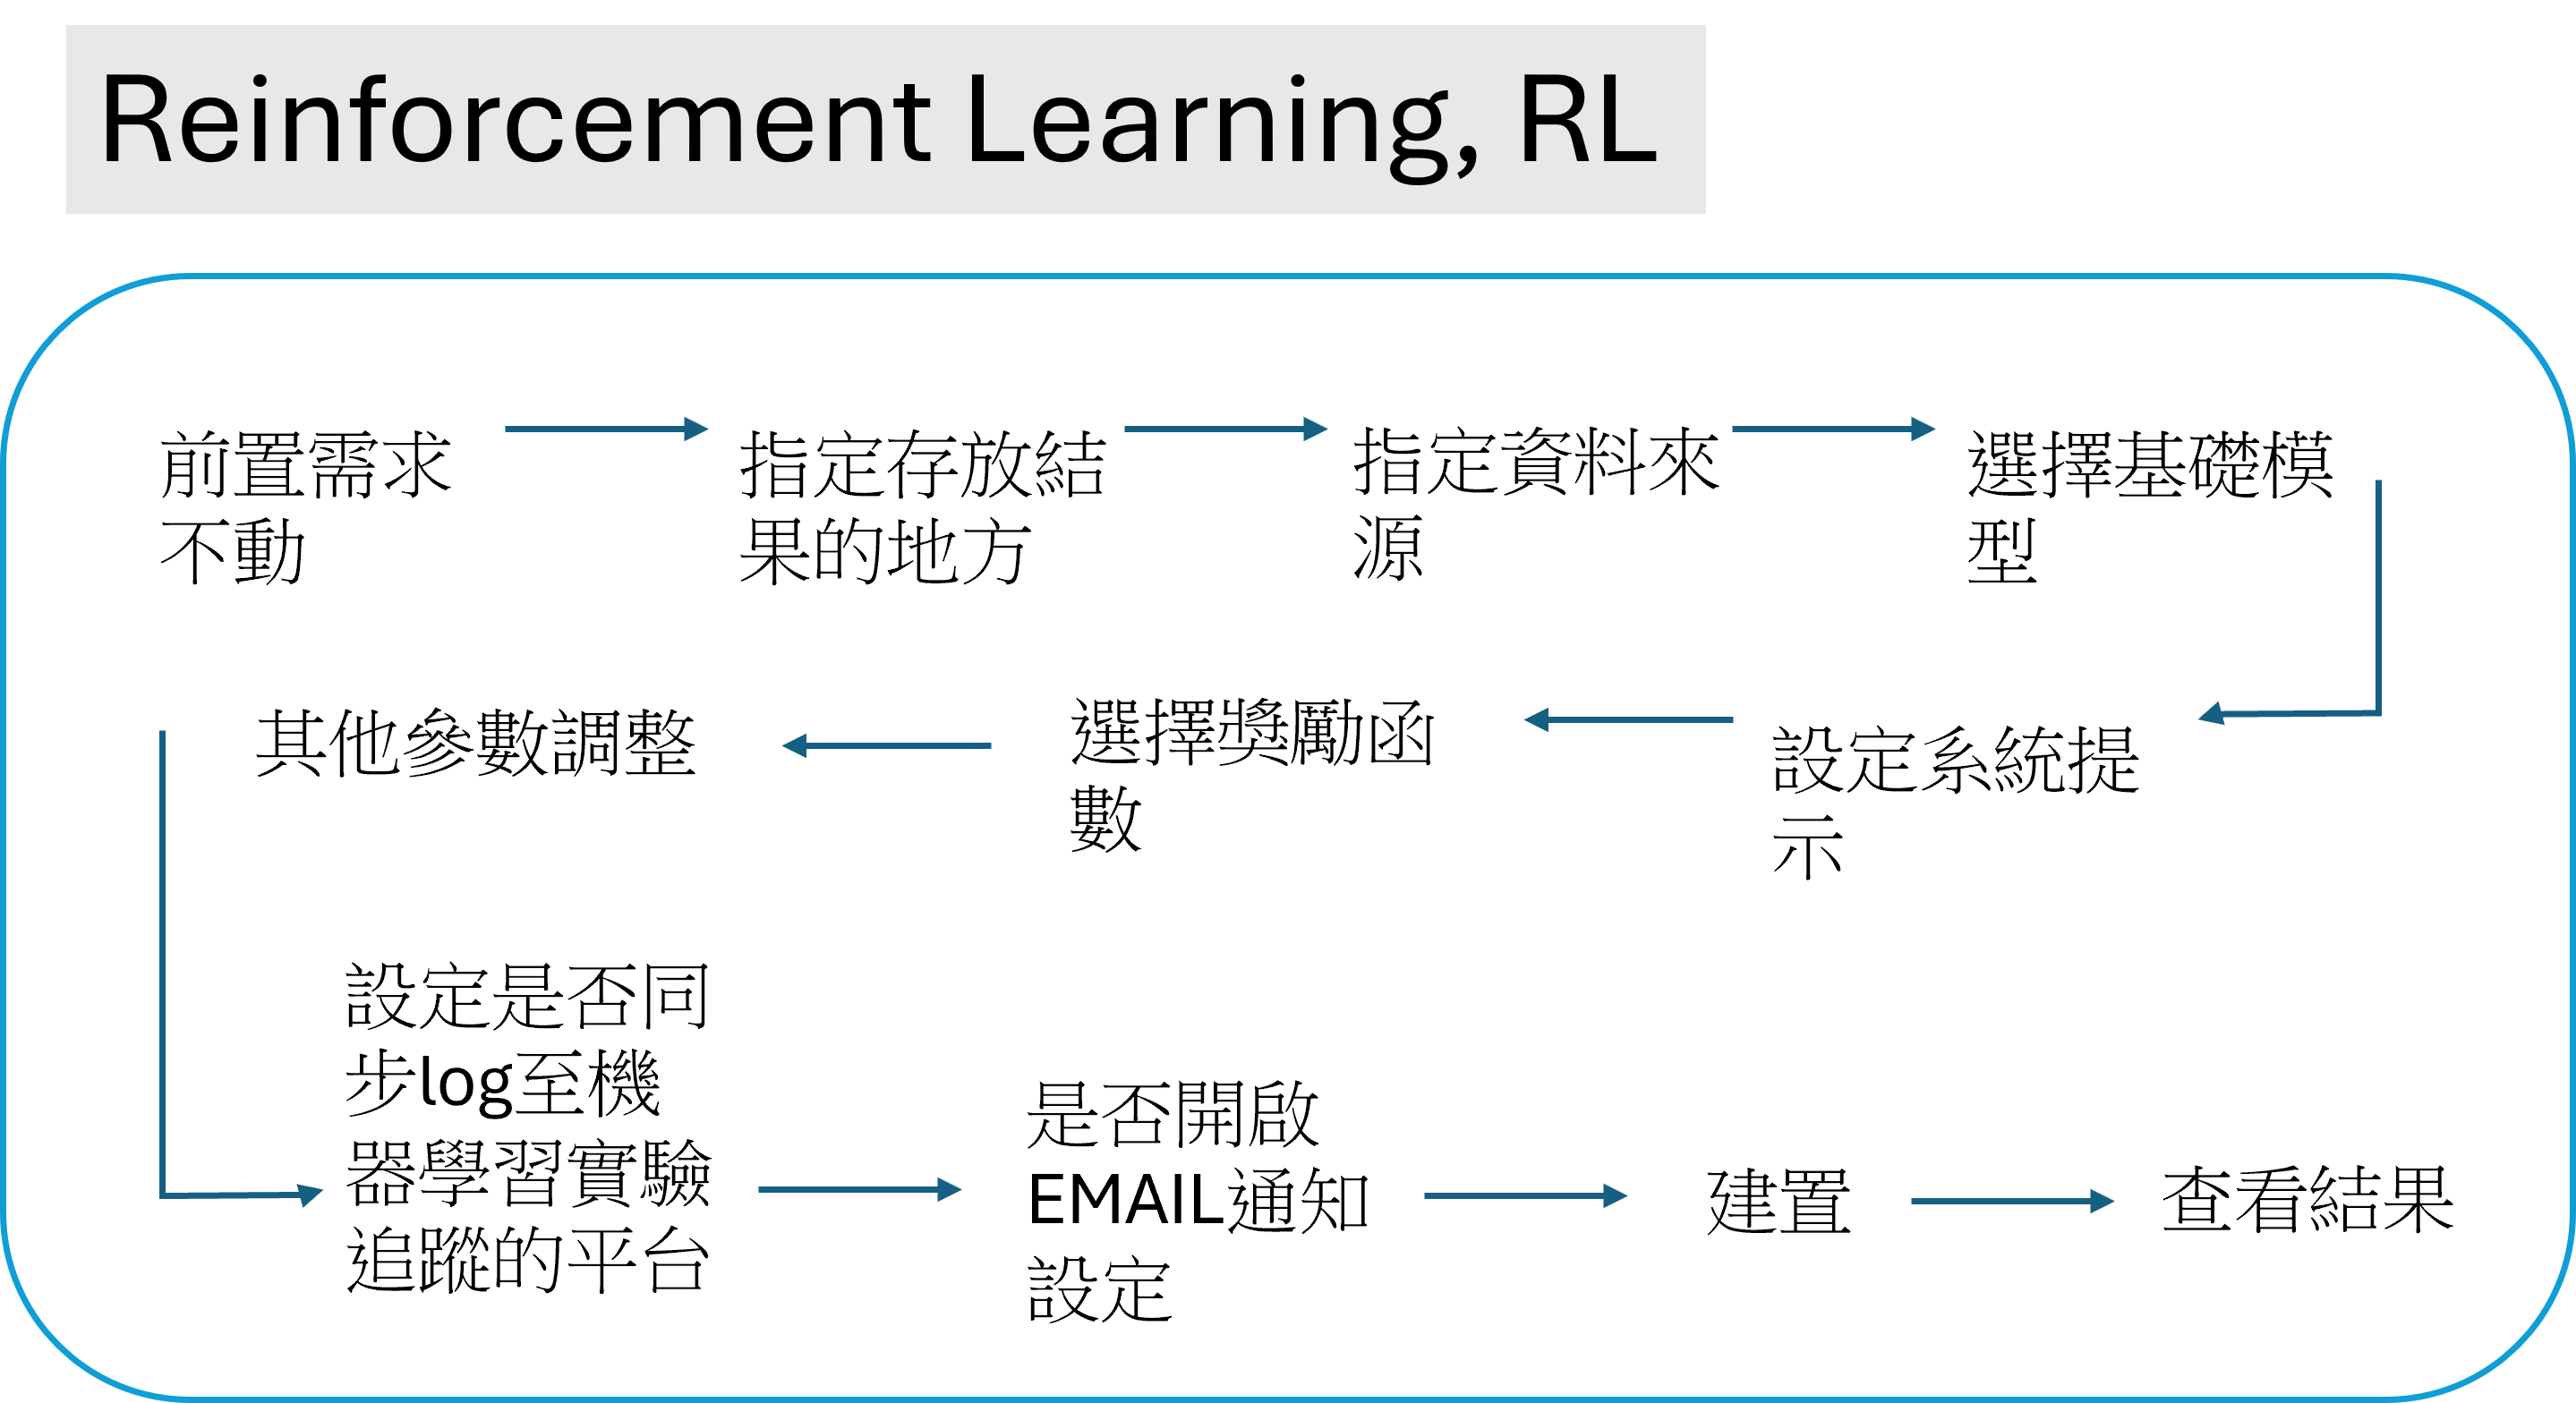


輸出結果
- 模型 SFT (Supervised Fine-Tuning) 訓練服務
資料生成後會自動上傳至指定倉庫,結構如下:
# 全參數訓練
full_sft/
└── [時間戳]/
    ├── log/      # 訓練日誌與監控數據
    ├── model/    # 轉換後的HuggingFace格式模型
    └── model_fapm_pruned_p{ratio}/ # 若有開啟 FAPM
# LoRA 訓練
lora_sft/
└── [時間戳]/
    ├── log/      # 訓練日誌與監控數據
    ├── model/    # 轉換後的HuggingFace格式模型
    └── model_fapm_pruned_p{ratio}/ # 若有開啟 FAPM
- 模型強化學習 (Reinforcement learning, RL) 訓練服務
資料生成後會自動上傳至指定倉庫,結構如下:
# 全參數訓練
full_GRPO(GSPO)/
└── [時間戳]/
    ├── logs/     # 訓練日誌與監控數據
    └── model/    # 轉換後的HuggingFace格式模型
# LoRA 訓練
lora_GRPO(GSPO)/
└── [時間戳]/
    ├── logs/     # 訓練日誌與監控數據
    └── model/    # 轉換後的HuggingFace格式模型
- 模型剪枝(Forgetting-Aware Pruning Metric)服務
執行完成後會自動上傳至指定倉庫,結構如下:
FAPM/
└── [時間戳]/
    └── model_fapm_pruned_p{ratio}/
- 模型直接偏好最佳化(Direct Preference Optimization, DPO) 訓練服務
執行完成後會自動上傳至指定倉庫,結構如下:
# 全參數訓練
full_dpo/
└── [時間戳]/
    ├── log/      # 訓練日誌與監控數據
    └── model/    # 轉換後的HuggingFace格式模型
# LoRA 訓練
lora_dpo/
└── [時間戳]/
    ├── log/      # 訓練日誌與監控數據
    └── model/    # 轉換後的HuggingFace格式模型
模型微調訓練(SFT)操作說明
- 登入 Portal 平台
- 平台左側選擇模型微調點選建立模型微調服務
- 至服務列表選擇所需服務,進入參數設定頁面設定參數。
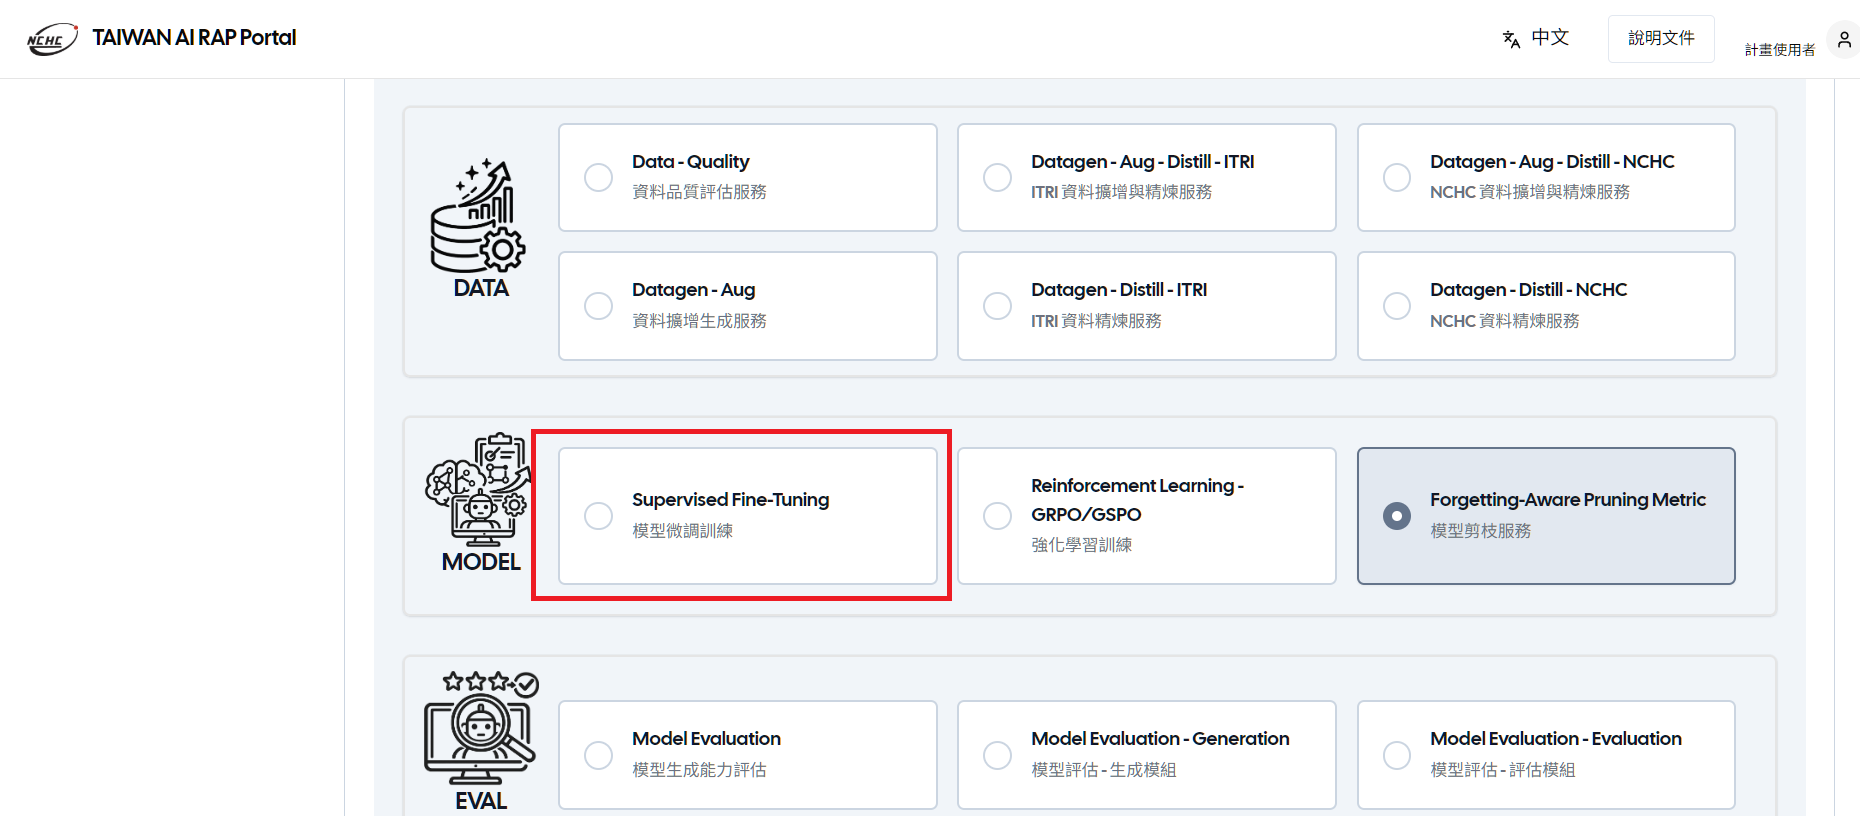
(請點擊展開參數設定說明)
- 設定 結果輸出路徑
-
GIT REPO URL:資料集所在的 GitLab Repository URL
-
GIT TOKEN:該 Repository 的存取令牌

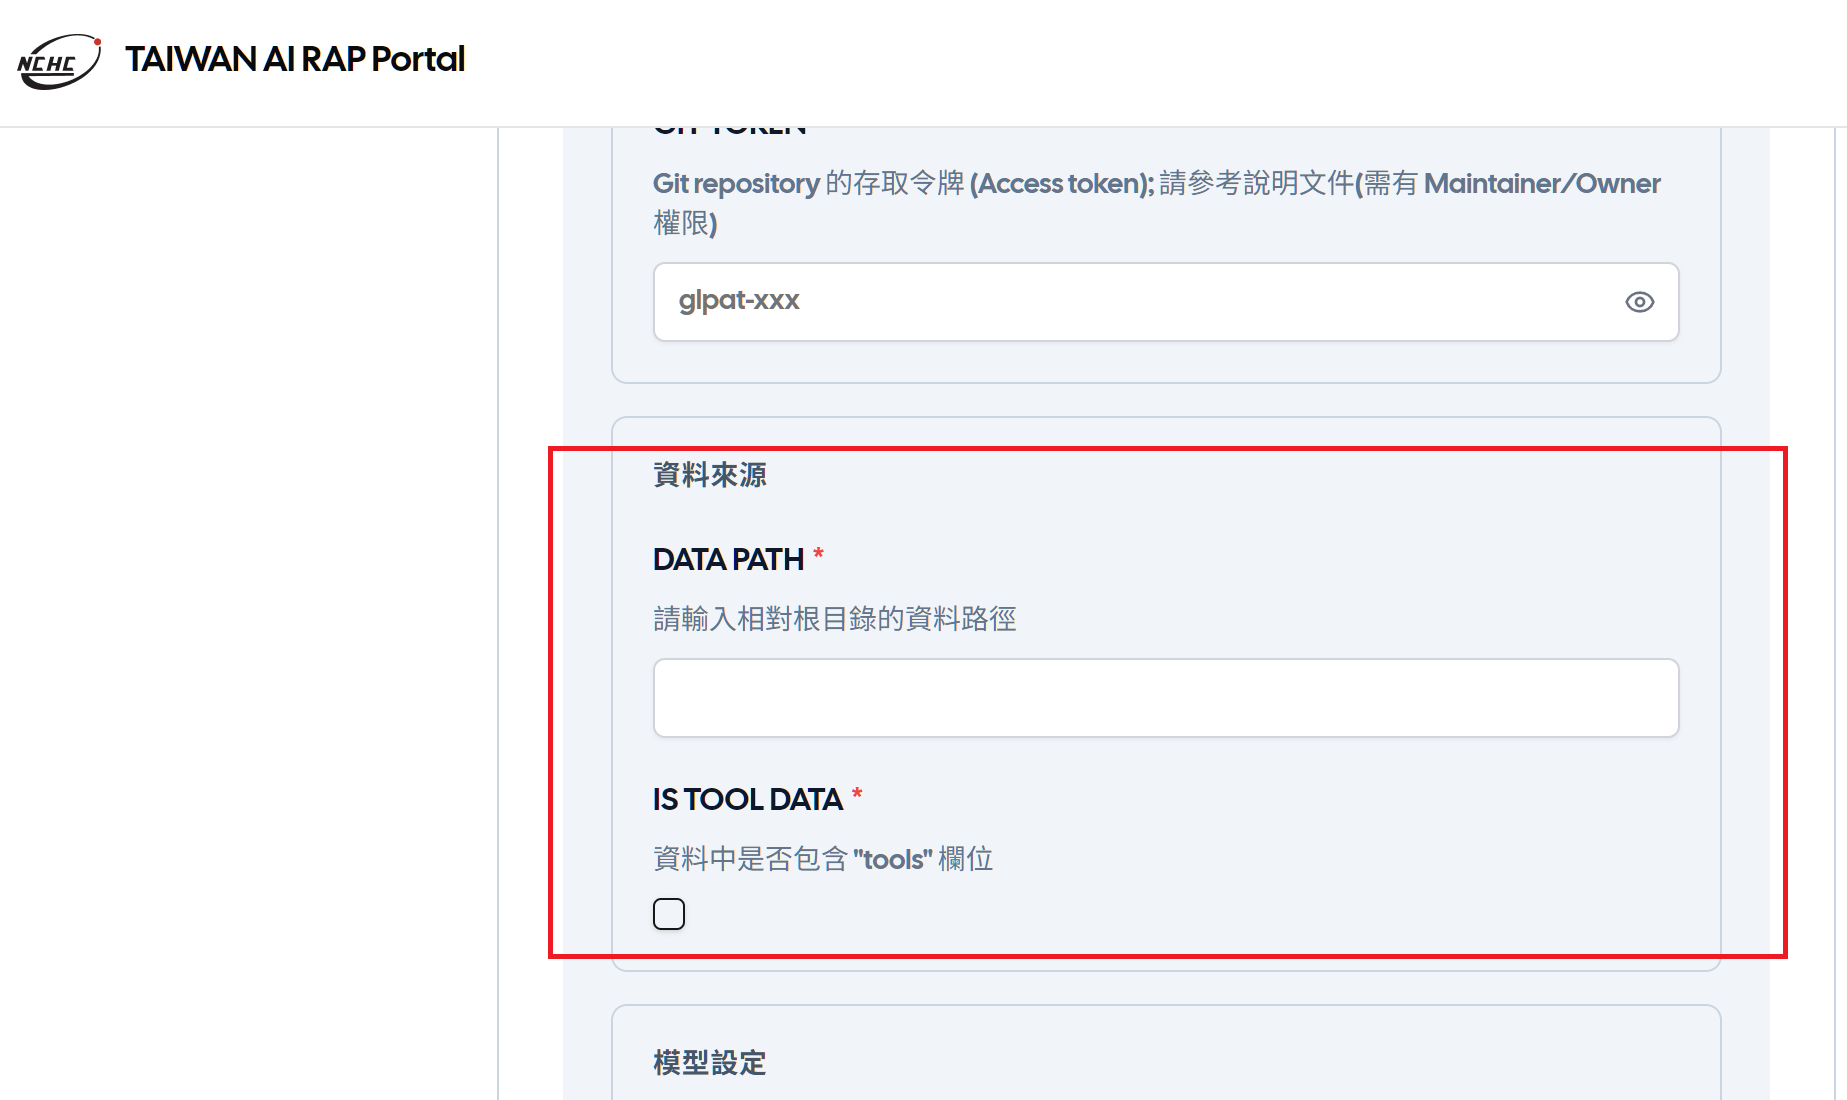
- 指定資料來源
-
DATA PATH:訓練資料集的相對路徑
-
IS TOOL DATA:判斷資料中是否包含 "tools" 欄位,預設不勾選
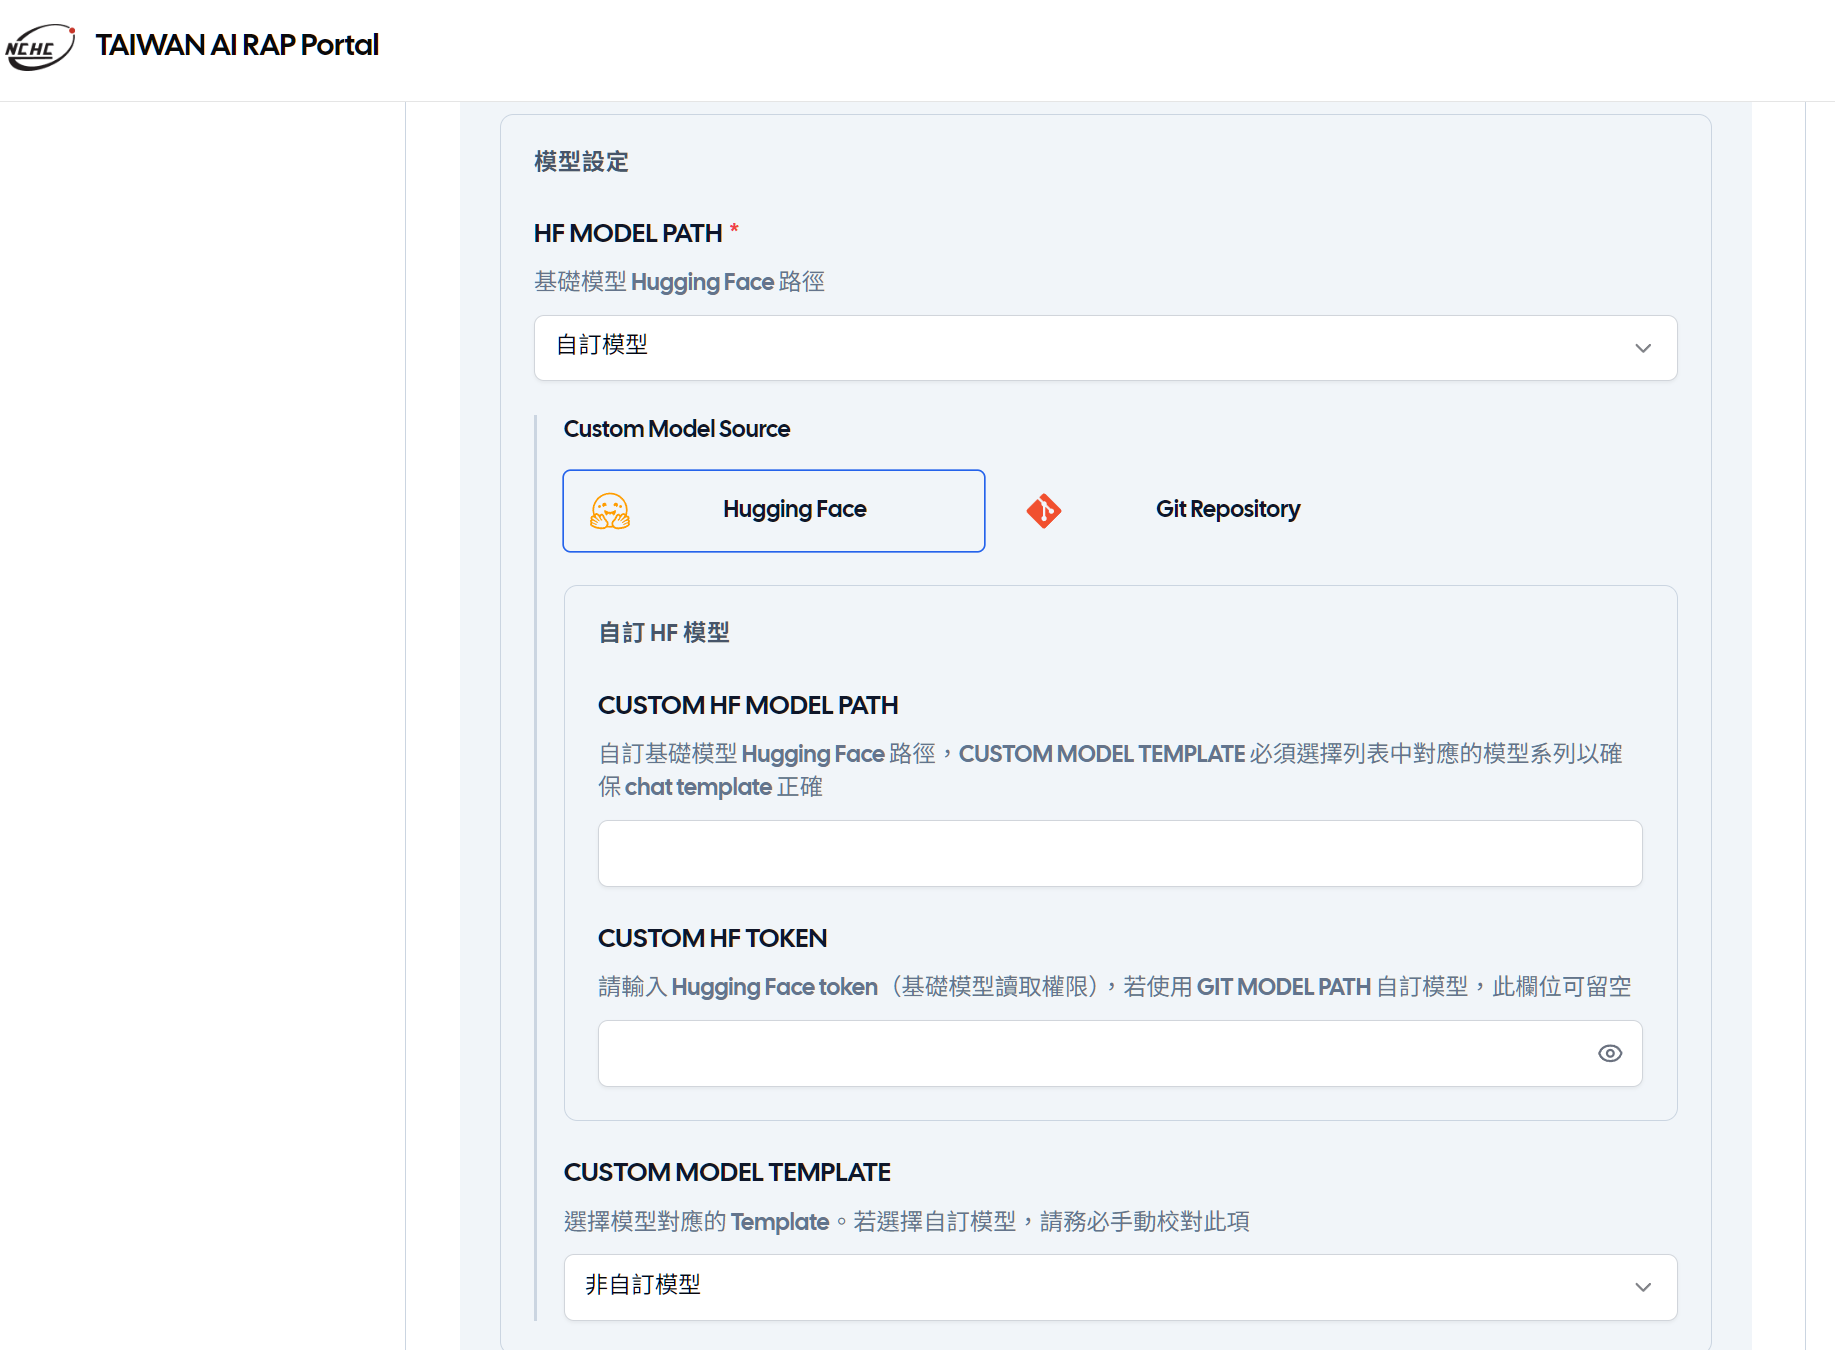
- 選擇基礎模型
-
可直接選擇既有的模型選項會直接存取好路徑供使用

-
也可選擇自訂模型的選項,自行設定既有欄位沒有的模型,模型存取分為Hugging Face及Git Repository兩種方式,請依介面提示填入兩者官方相對應提供的模型路徑並做設定 (僅能訓練小模型)
- 其他參數調整:
-
設定硬體
-
GPU_COUNT:可選擇
1 / 2 / 4 / 8- GPU 數量越少 → 訓練時間越長
- GPU 數量越多 → 訓練速度越快,但需更多資源
-
設定訓練方式
-
其他參數若無特殊需求,不須特別更動設定,或按介面指示設定,詳細可見
LLM訓練服務參數說明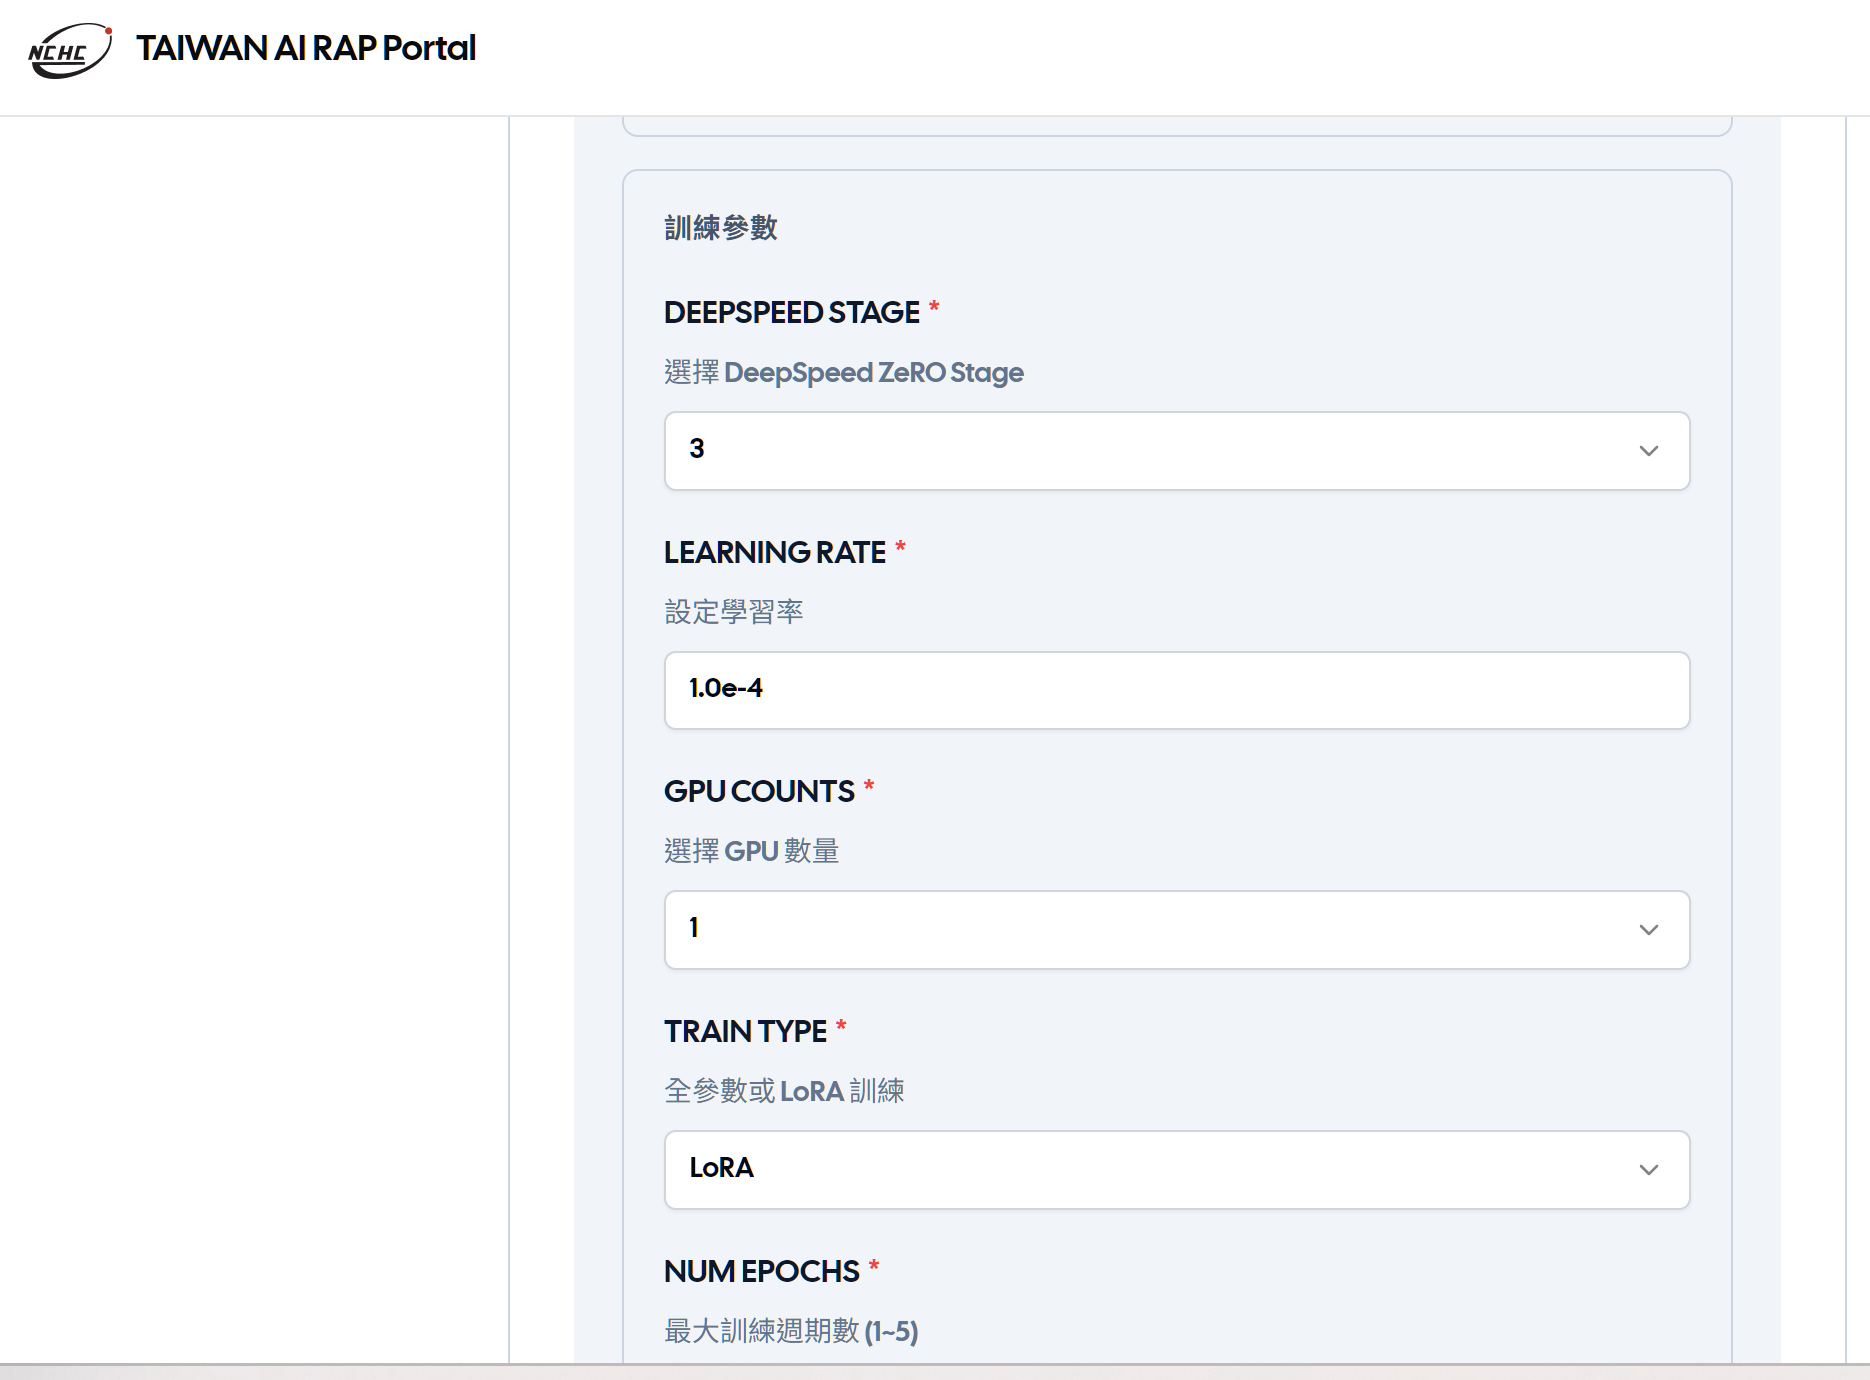
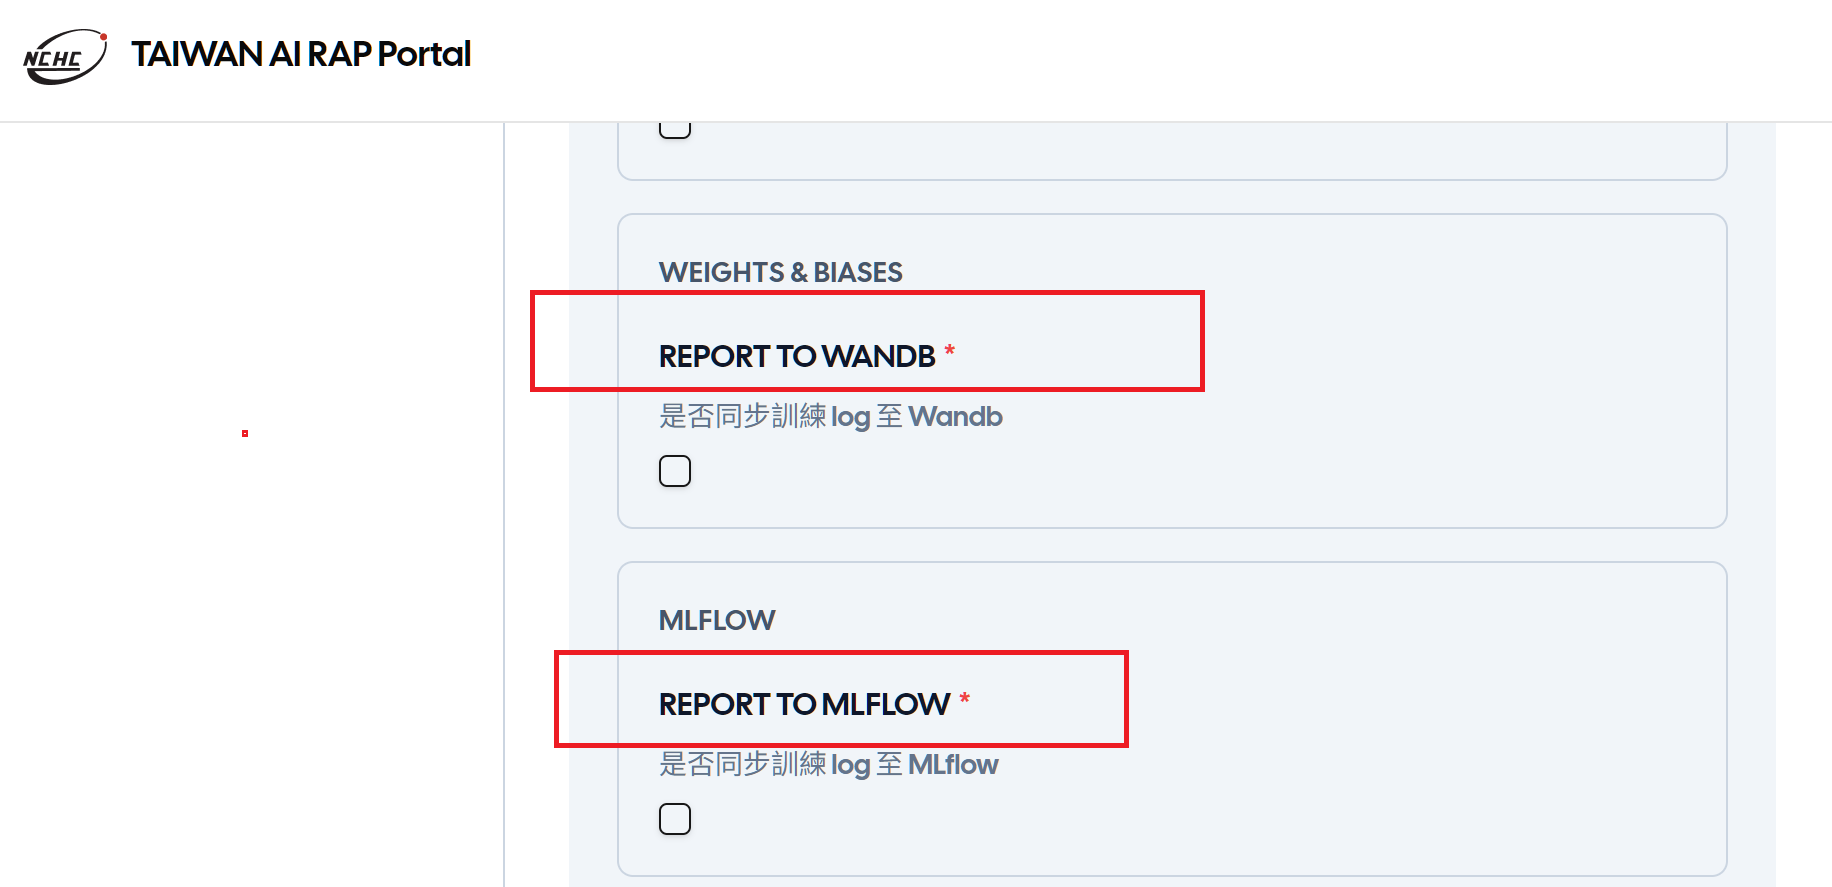
- 設定是否同步訓練log至機器學習實驗追蹤的平台:
-
同步至Wandb : 用來記錄、比較、可視化與管理機器學習實驗的工具
-
同步至MLflow : 用來管理模型訓練、版本與部署的 MLOps 平台
-
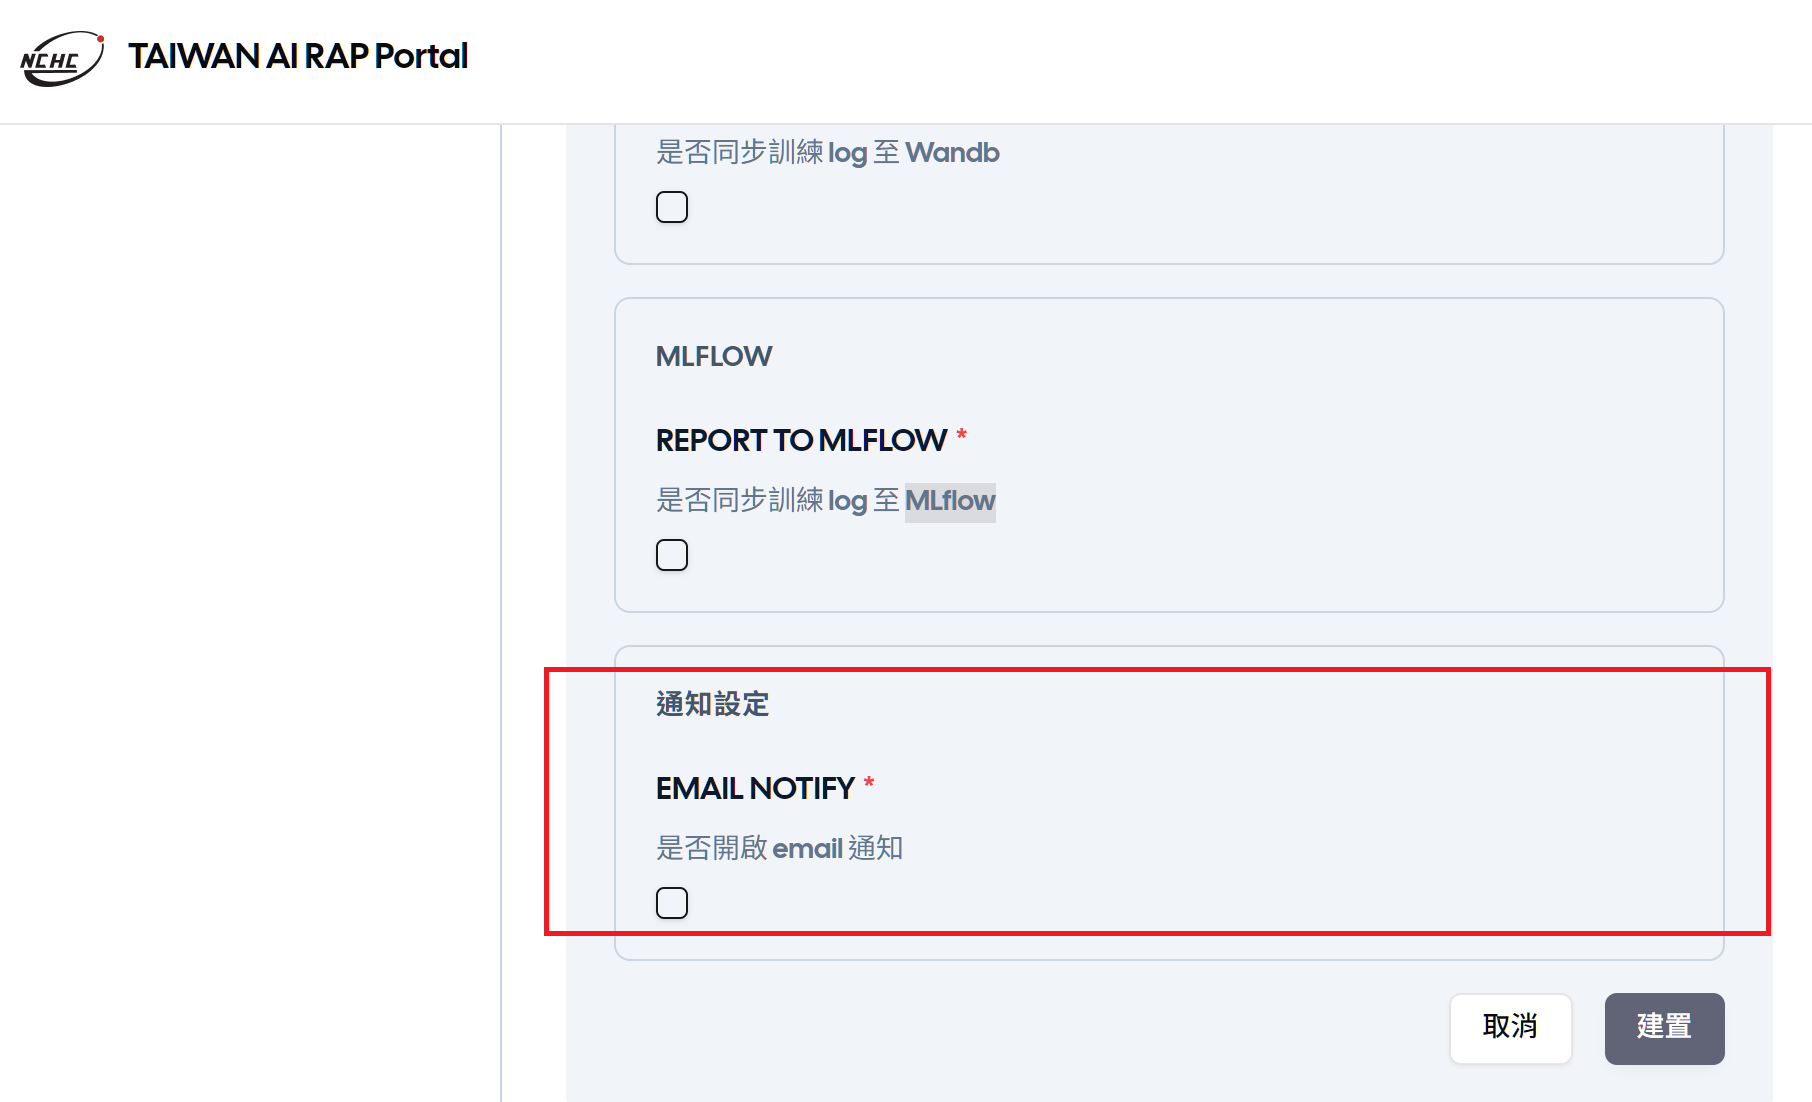
是否開啟EMAIL通知設定:如果開啟,請輸入電子郵件地址。
- 確認無誤後,點擊 「建置」 按鈕,平台會自動執行
下載資料集、載入基礎模型、啟動 GPU 訓練流程 - 查看結果,訓練完成後,結果會儲存在指定的 Repository 記錄中。
強化學習訓練(RL)操作說明
- 登入 Portal 平台
- 平台左側選擇模型微調點選建立模型微調服務
- 至服務列表選擇所需服務,進入參數設定頁面設定參數。
(請點擊展開參數設定說明)
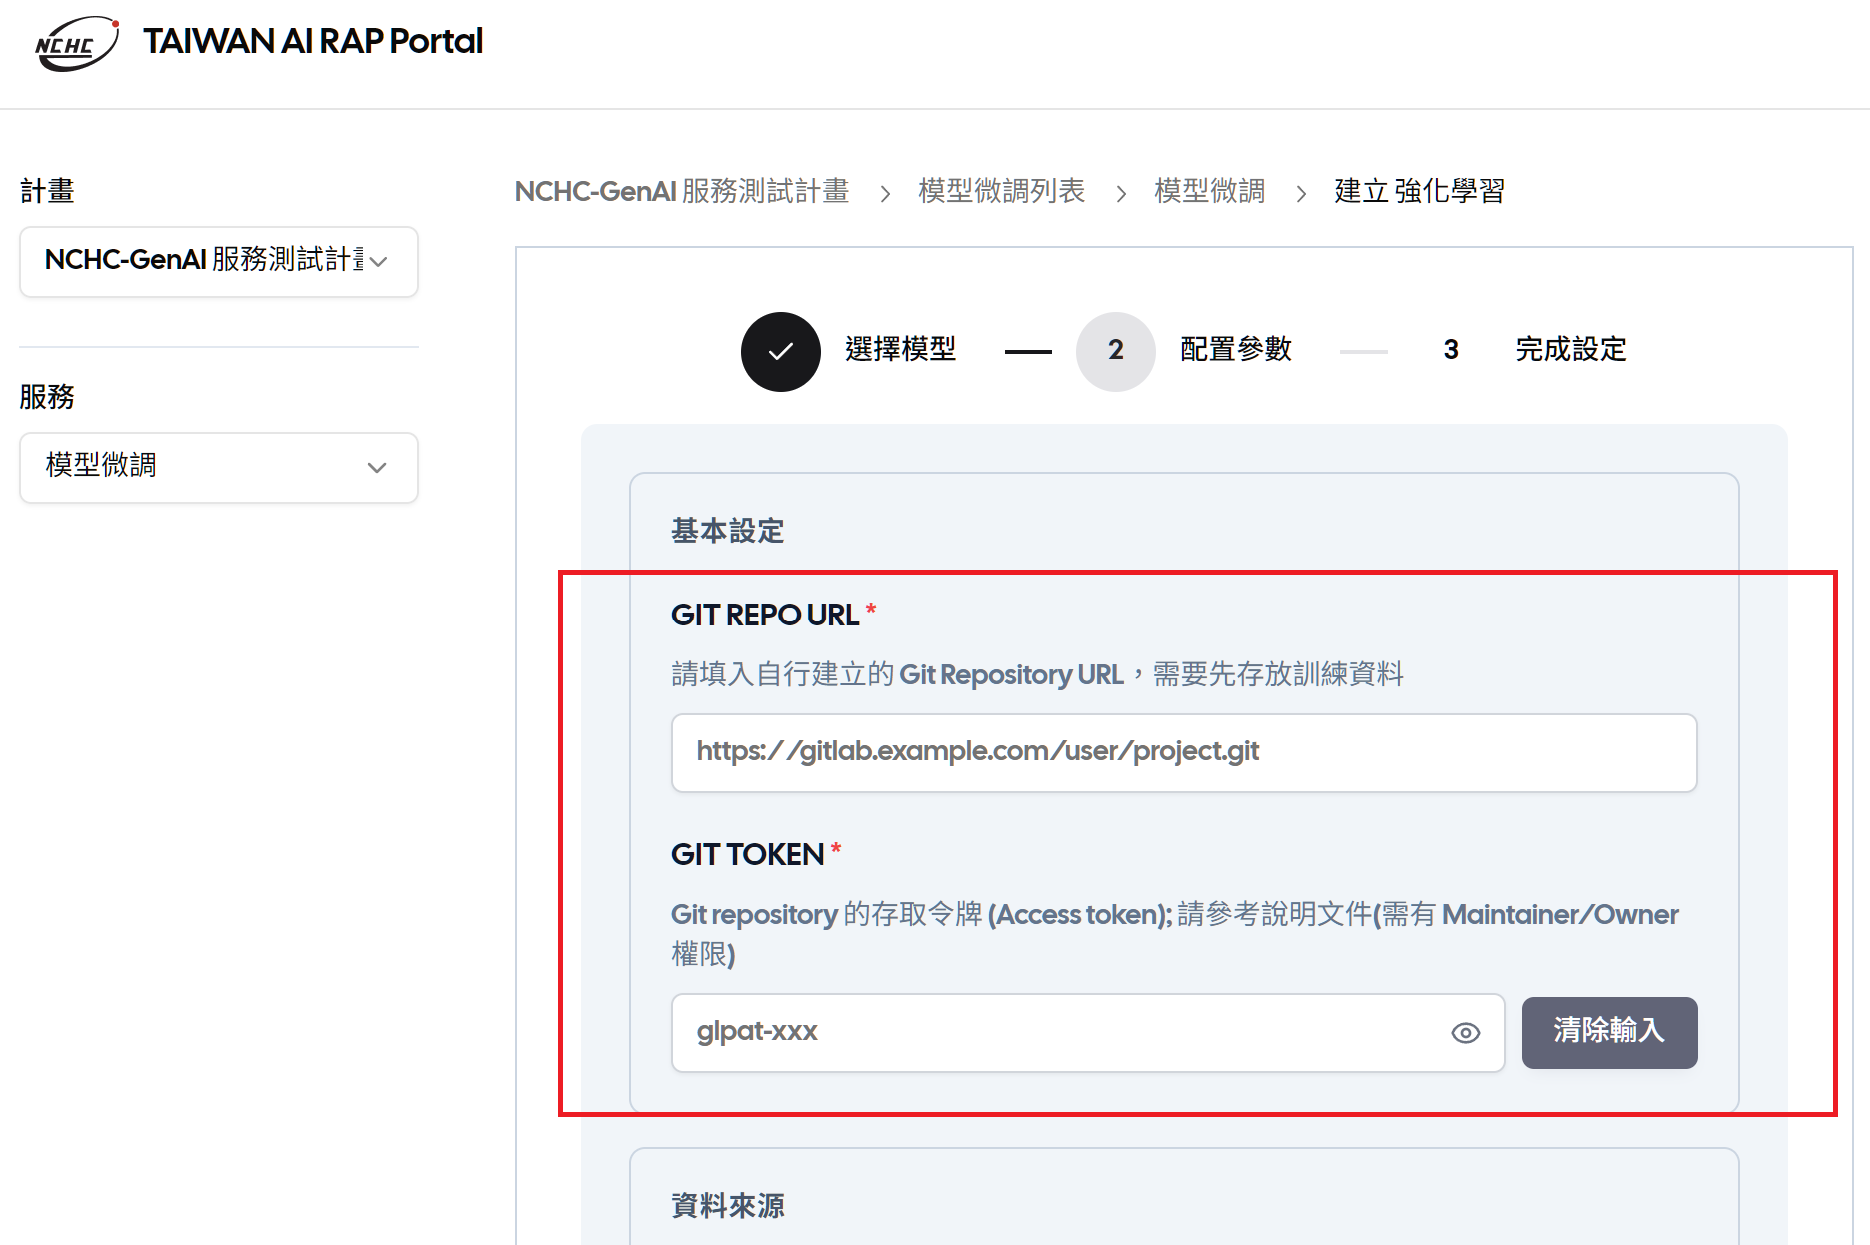
- 設定 結果輸出路徑
-
GIT REPO URL:資料集所在的 GitLab Repository URL
-
GIT TOKEN:該 Repository 的存取令牌
- 指定資料來源
-
DATA PATH:訓練資料集的相對路徑
-
RL METHOD:RL 的訓練方法,提供 GRPO/GSPO 作選擇
-
Q COL:資料中作為【問題】的欄位名稱。若您上傳的資料已經是 GRPO/GSPO 格式,請留空此欄位。
-
A COL:資料中作為【答案】的欄位名稱。若您上傳的資料已經是 GRPO/GSPO 格式,請留空此欄位。

- 選擇基礎模型
-
可直接選擇既有的模型選項會直接存取好路徑供使用

-
也可選擇自訂模型的選項,自行設定既有欄位沒有的模型,模型存取分為Hugging Face及Git Repository兩種方式,請依介面提示填入兩者官方相對應提供的模型路徑並做設定 (僅能訓練小模型)
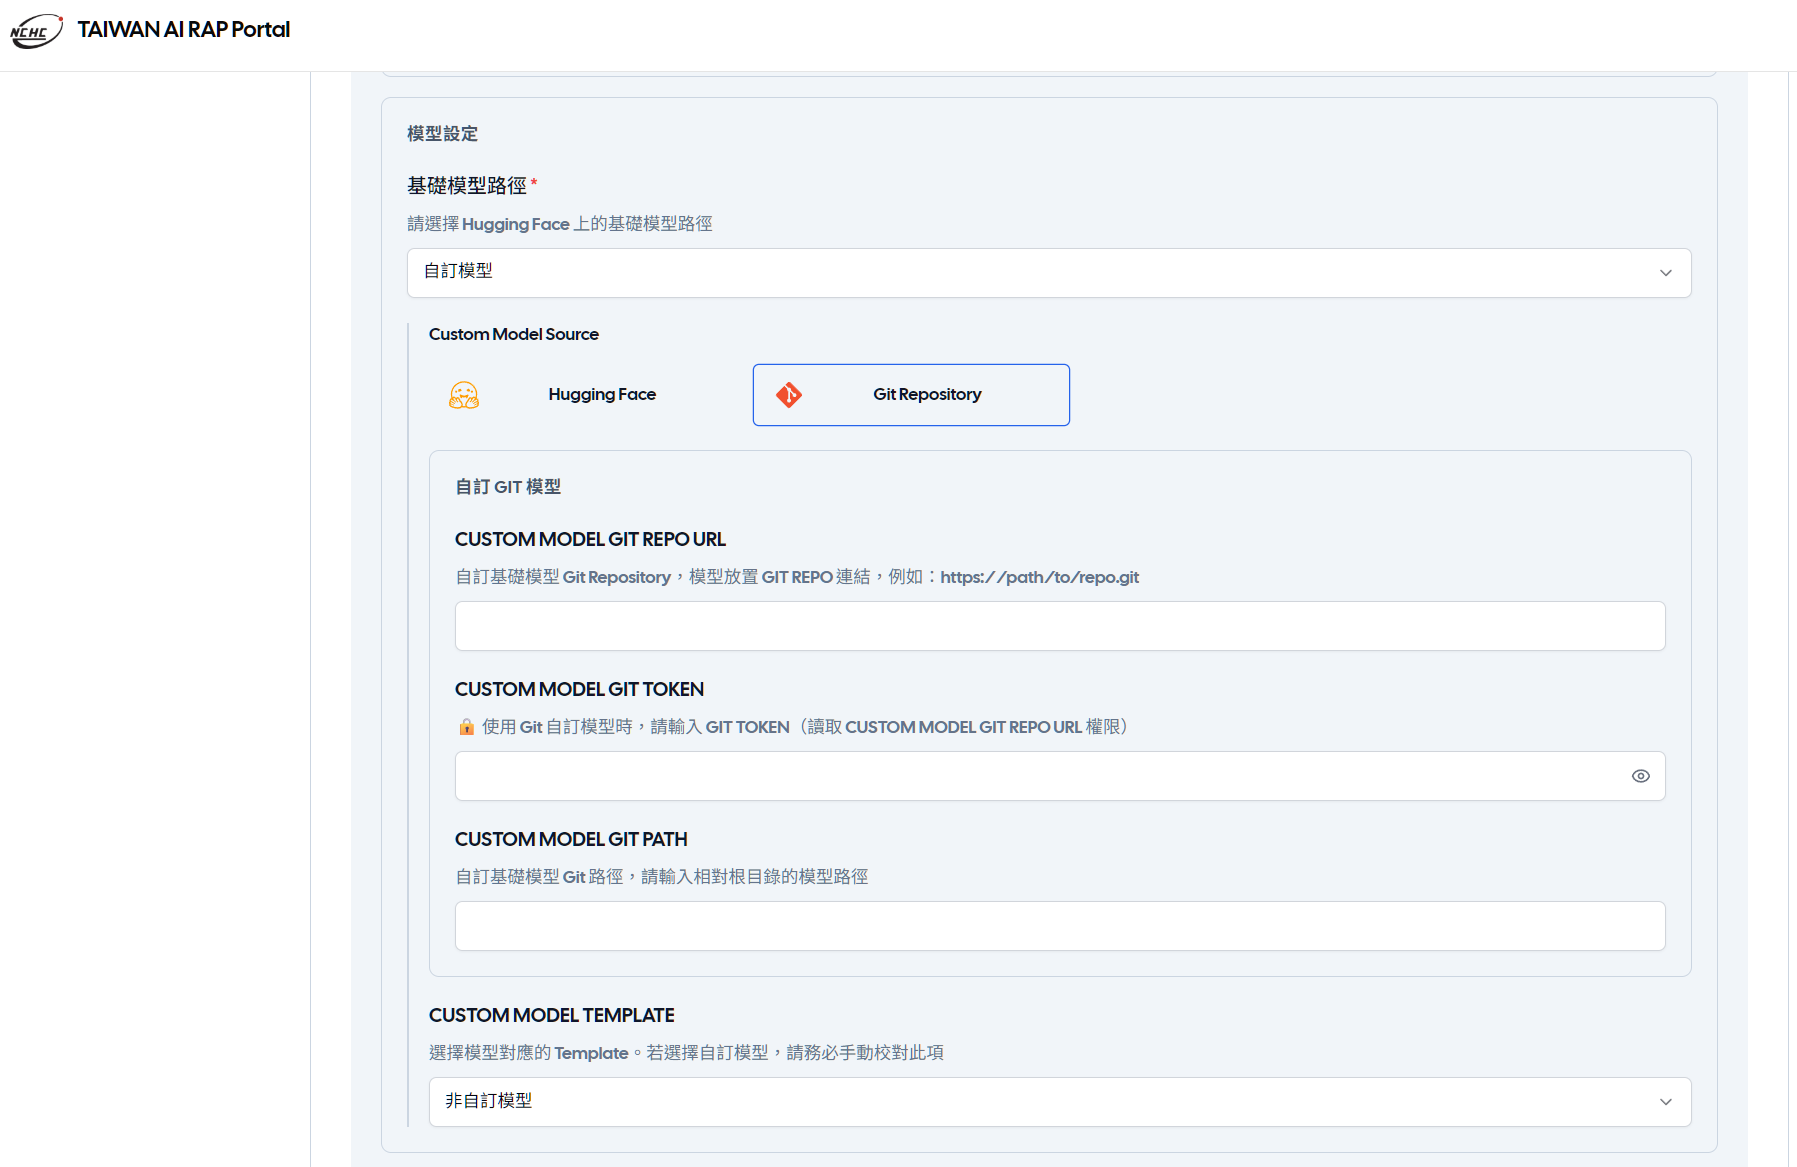
- 設定系統提示
- 分為預設及自訂,請依介面提示做設定

- 選擇獎勵函數
- 預設有
strict_format、tag_count、correctness、soft_correctness、int_reward可共複選,敘述如介面說明

- 其他參數調整:
-
設定硬體
-
GPU_COUNT:可選擇
1 / 2 / 4 / 8- GPU 數量越少 → 訓練時間越長
- GPU 數量越多 → 訓練速度越快,但需更多資源
-
設定訓練方式
-
其他參數若無特殊需求,不須特別更動設定,或按介面指示設定,詳細可見
LLM訓練服務參數說明
- 設定是否同步訓練log至機器學習實驗追蹤的平台:
-
同步至Wandb : 用來記錄、比較、可視化與管理機器學習實驗的工具
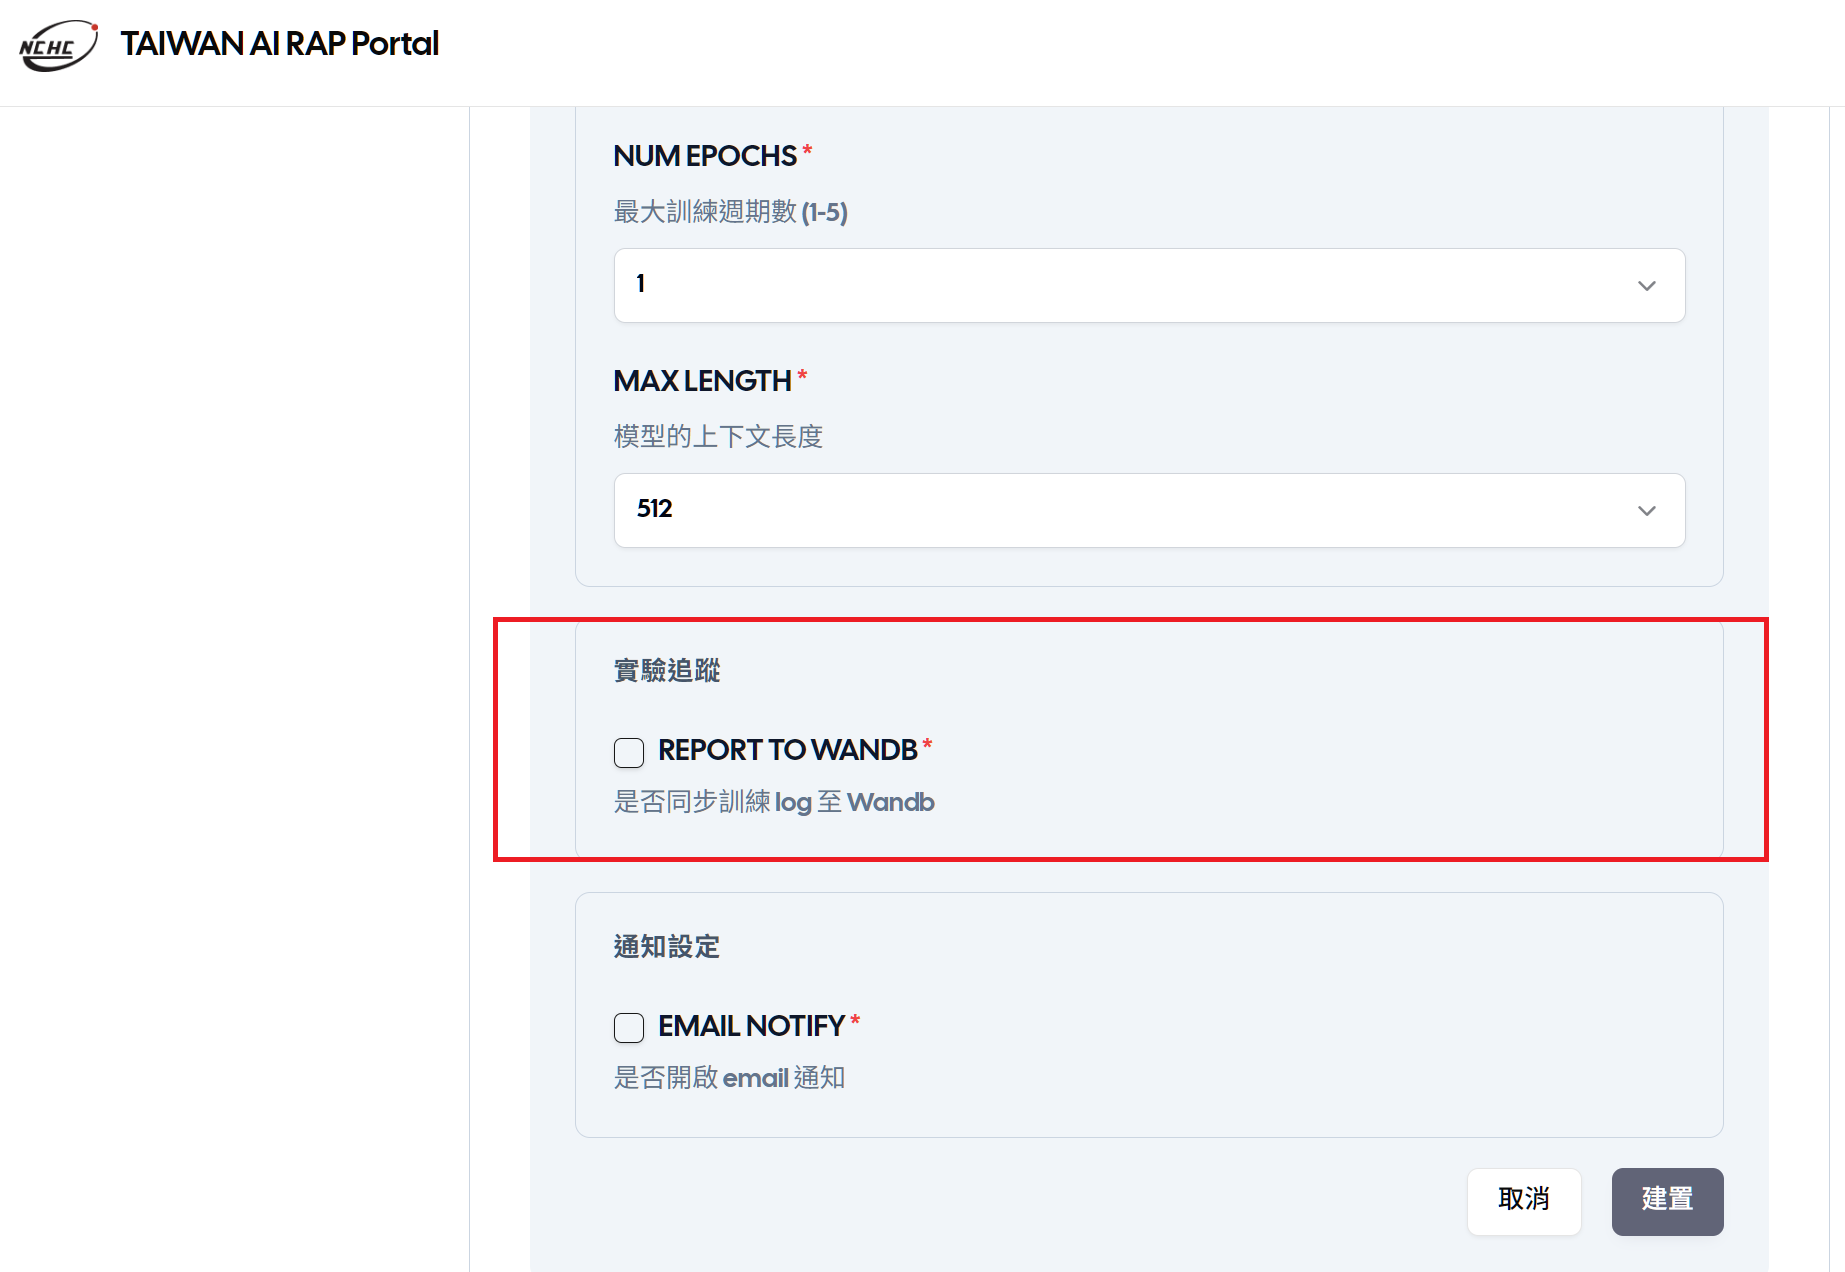
-
是否開啟EMAIL通知設定:如果開啟,請輸入電子郵件地址。
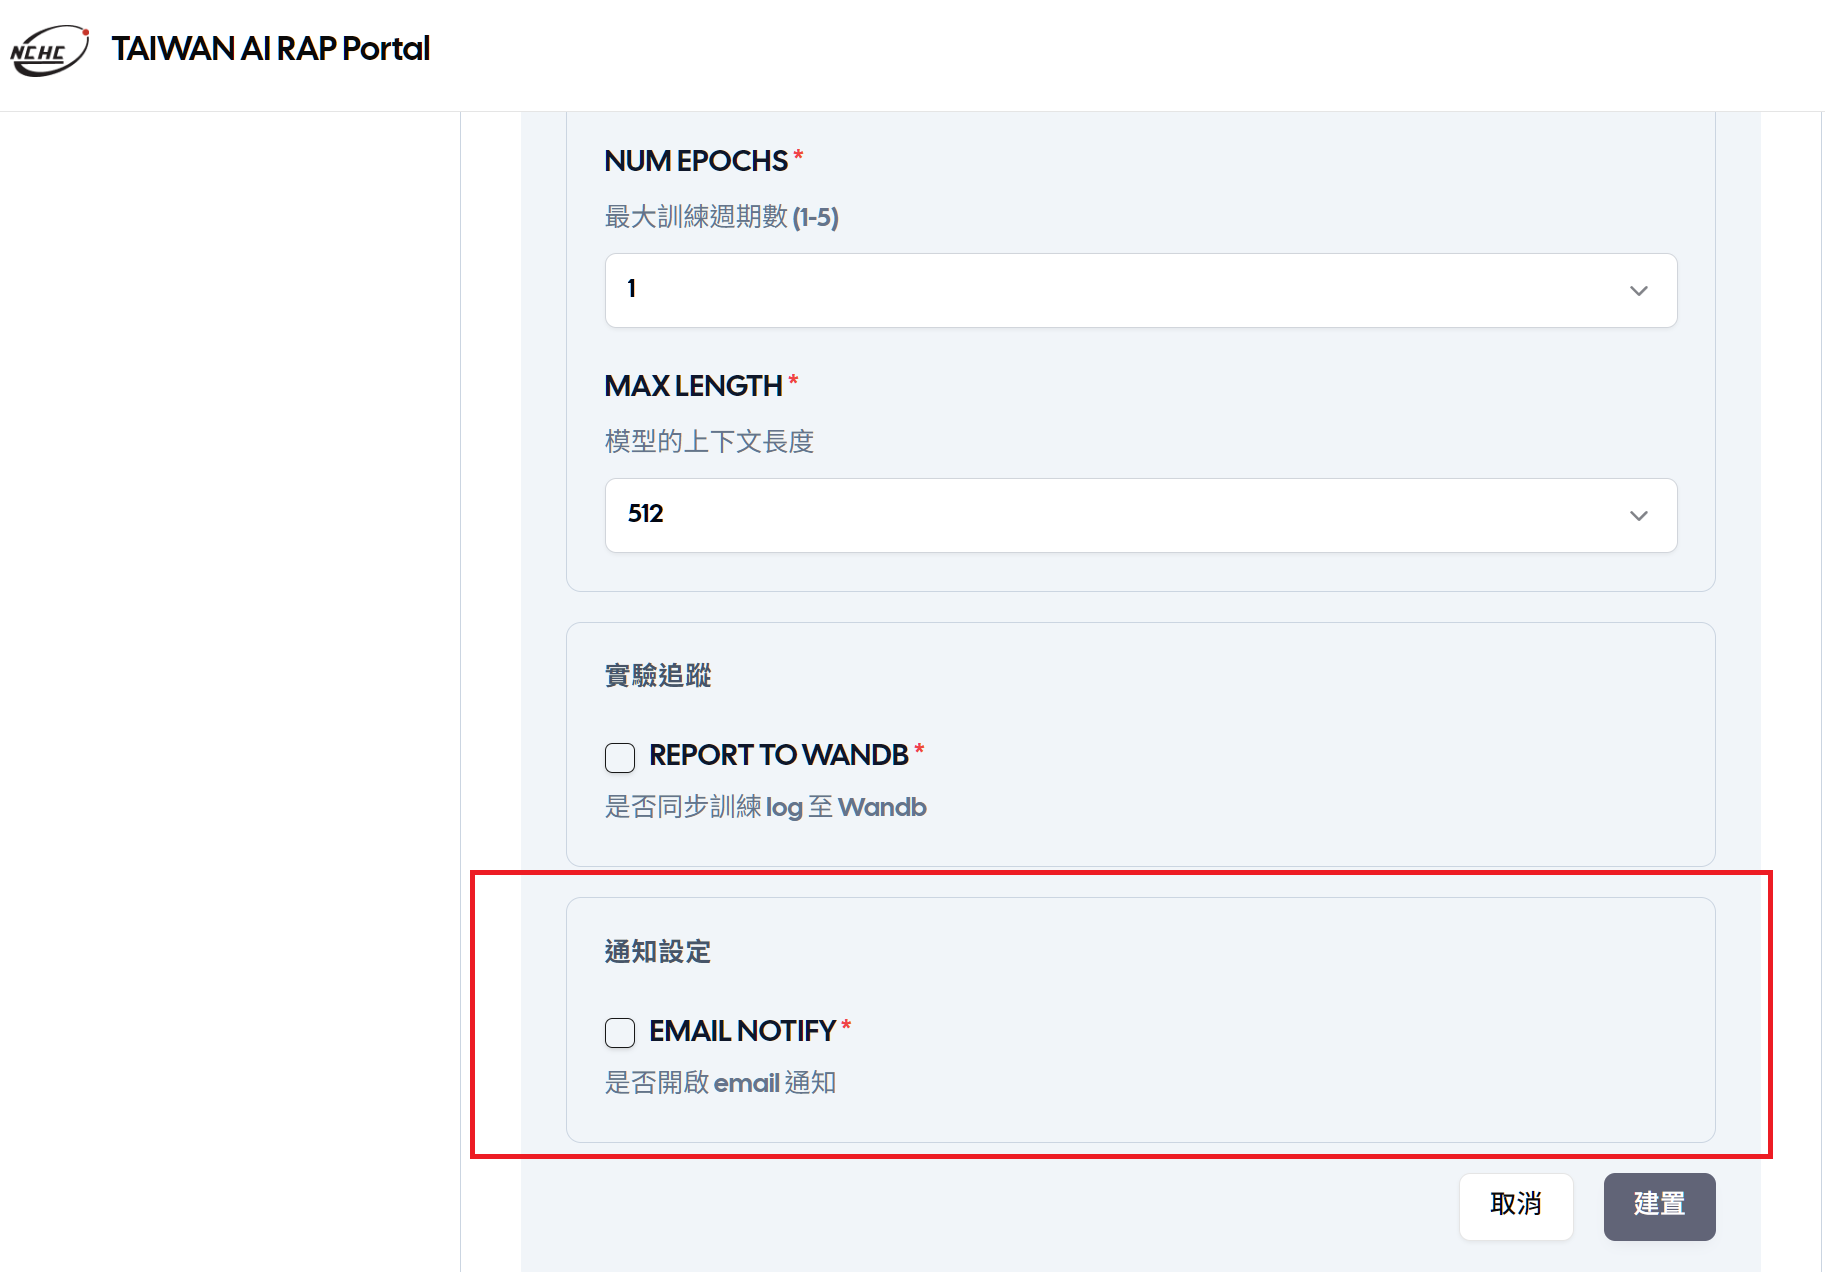
- 確認無誤後,點擊 「建置」 按鈕,平台會自動執行
下載資料集、載入基礎模型、啟動 GPU 訓練流程 - 查看結果,訓練完成後,結果會儲存在指定的 Repository 記錄中。
模型剪枝(Forgetting-Aware Pruning Metric)操作說明
- 登入 Portal 平台
- 平台左側選擇模型微調點選建立模型微調服務
- 至服務列表選擇所需服務,進入參數設定頁面設定參數。
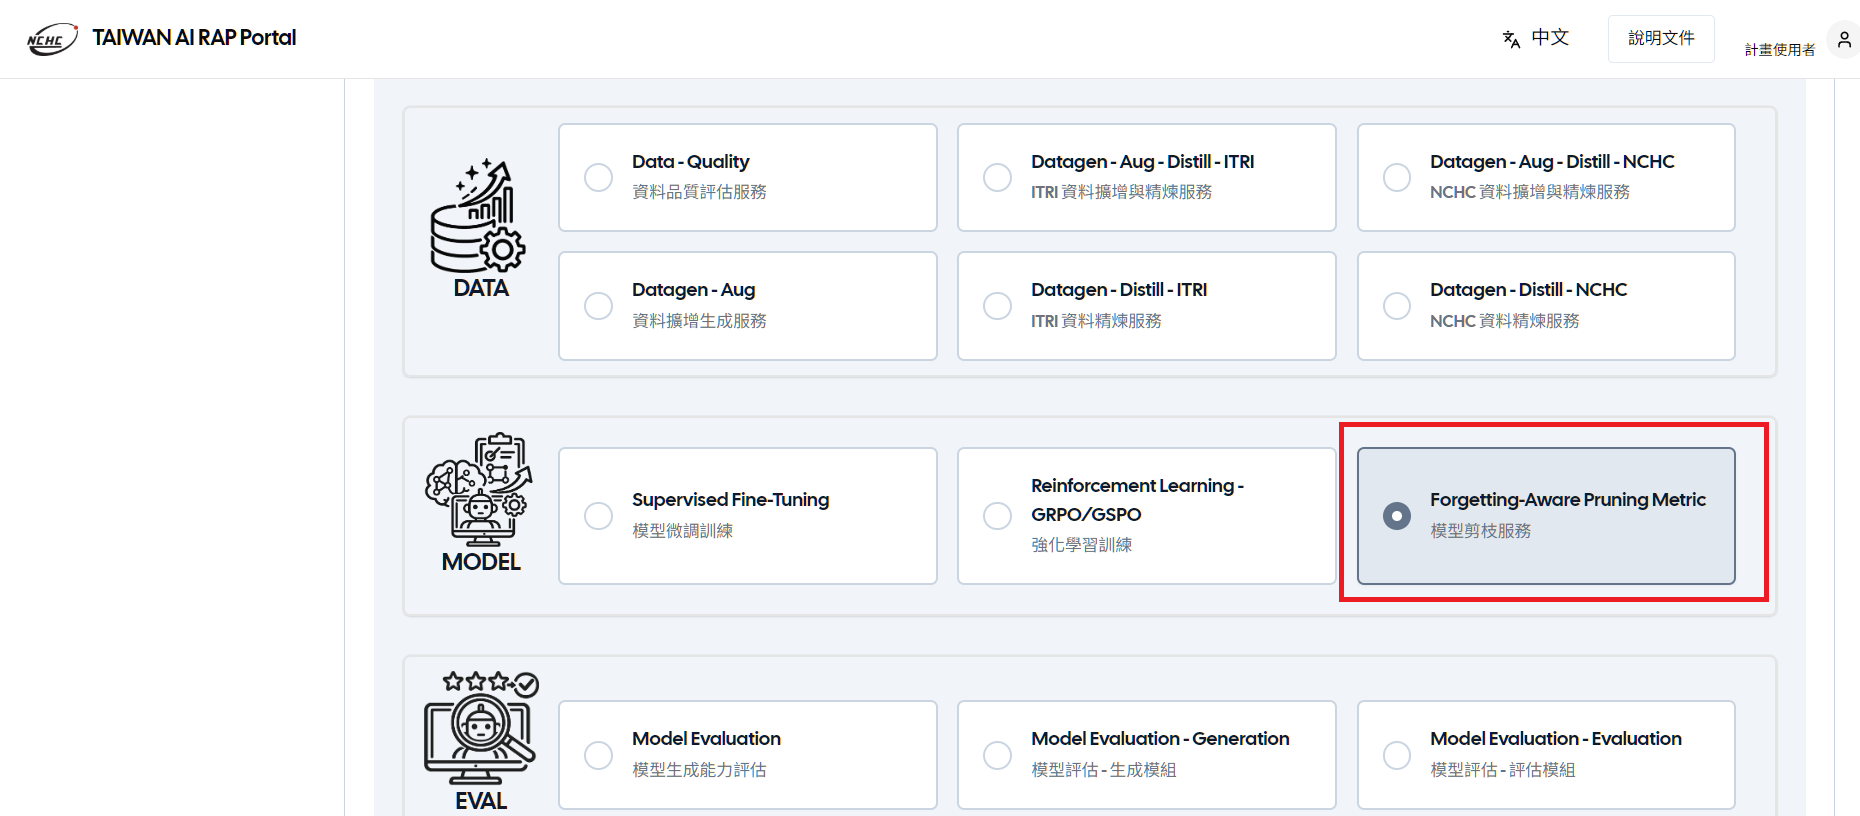
(請點擊展開參數設定說明)
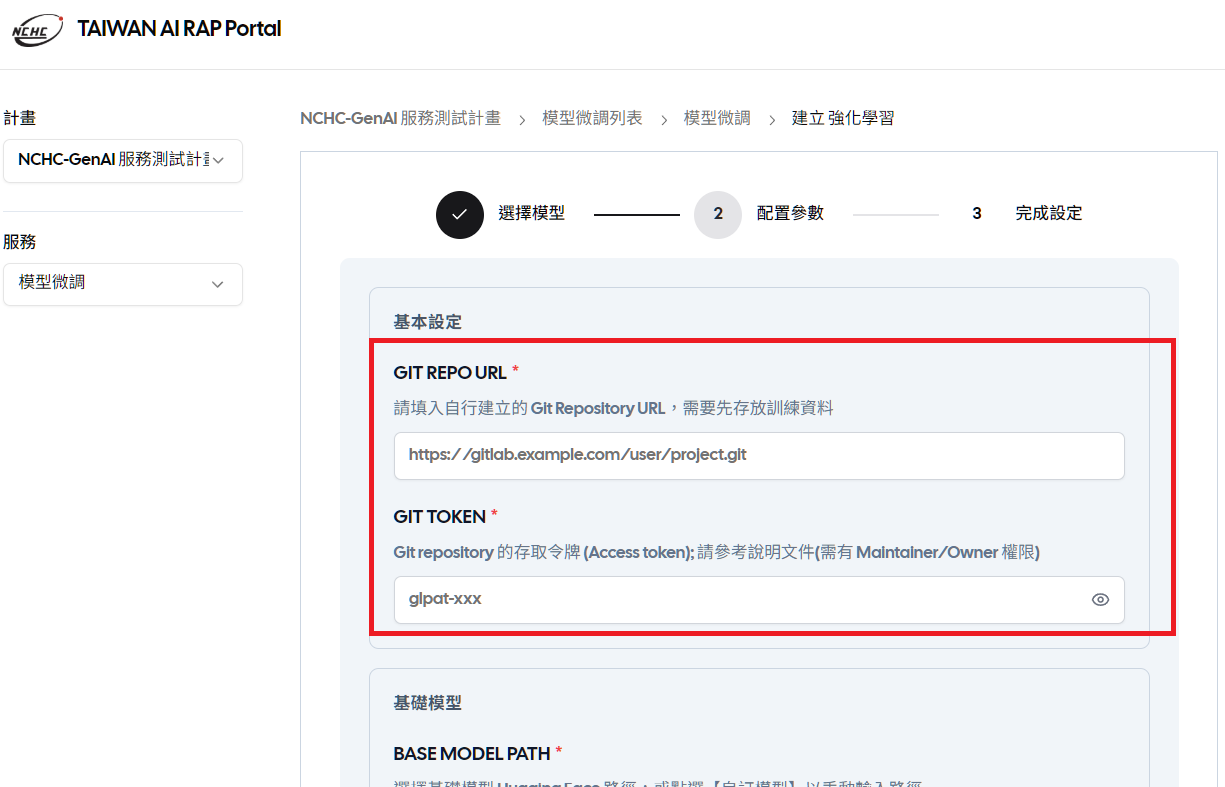
- 設定 結果輸出路徑
-
GIT REPO URL:資料集所在的 GitLab Repository URL
-
GIT TOKEN:該 Repository 的存取令牌
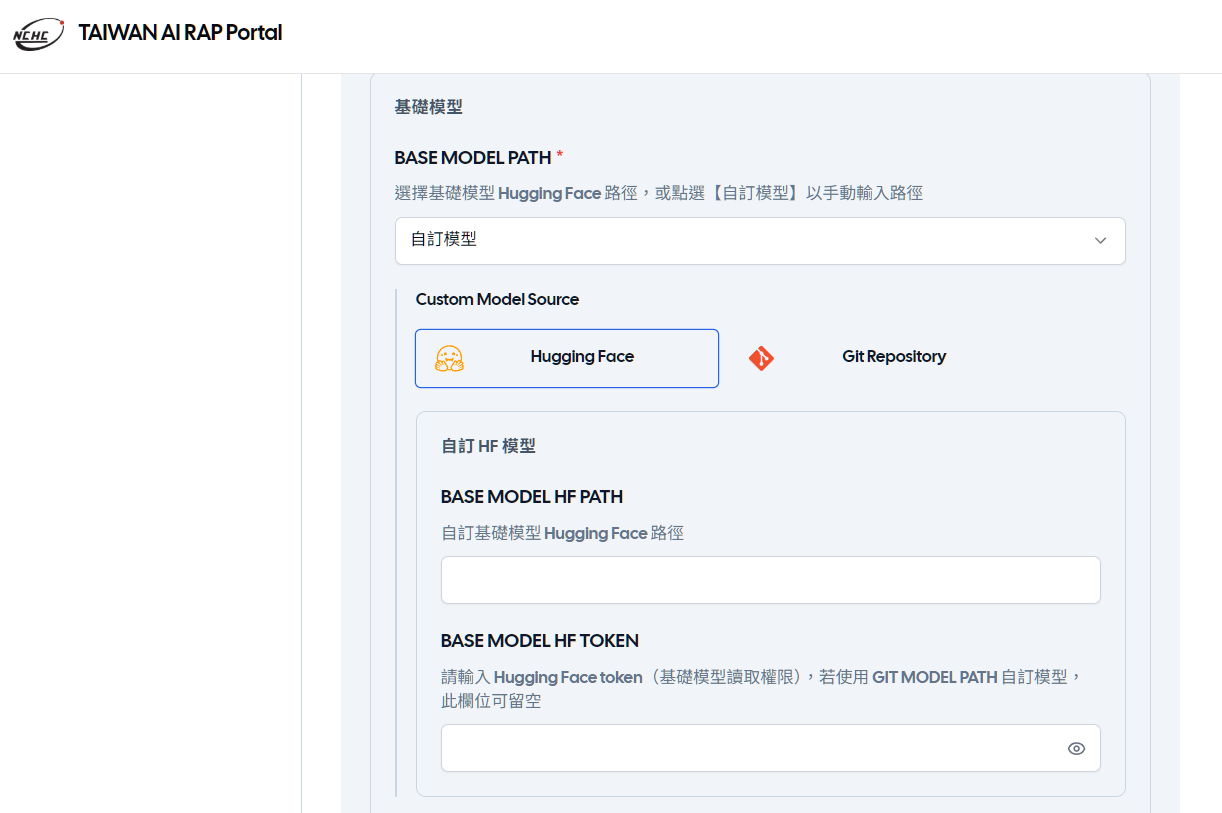
- 選擇基礎模型
-
可直接選擇既有的模型選項會直接存取好路徑供使用

-
也可選擇自訂模型的選項,自行設定既有欄位沒有的模型,模型存取分為Hugging Face及Git Repository兩種方式,請依介面提示填入兩者官方相對應提供的模型路徑並做設定 (僅能訓練小模型)
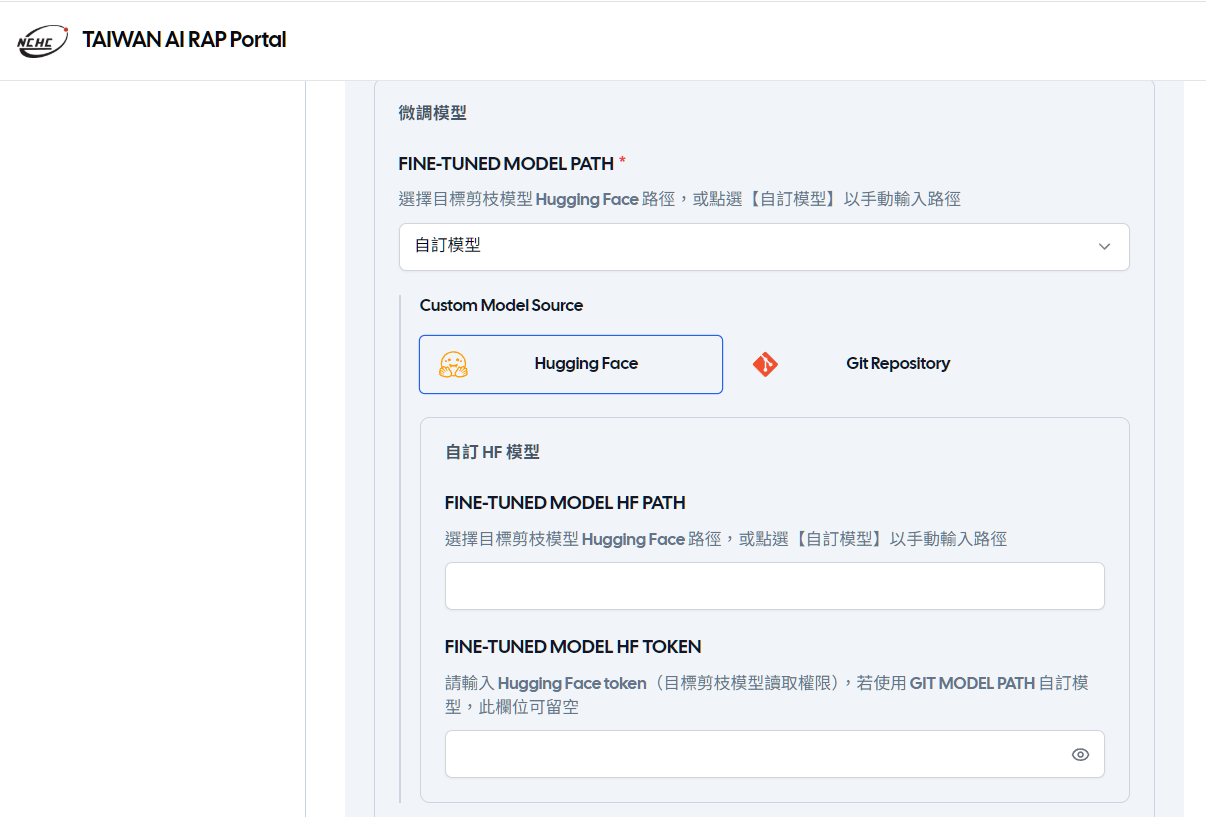
- 選擇微調模型
-
可直接選擇既有的模型選項會直接存取好路徑供使用

-
也可選擇自訂模型的選項,自行設定既有欄位沒有的模型,模型存取分為Hugging Face及Git Repository兩種方式,請依介面提示填入兩者官方相對應提供的模型路徑並做設定 (僅能訓練小模型)
- 剪枝參數調整:
-
數值範圍:0~1,數值越小 → 越多權重回到 Base(泛化性、通用能力佳);數值越大 → 越接近微調模型(專用任務性、通用能力較差)。全參數訓練模型建議:0.5、LoRA訓練建議:0.95,詳細可見
LLM訓練服務參數說明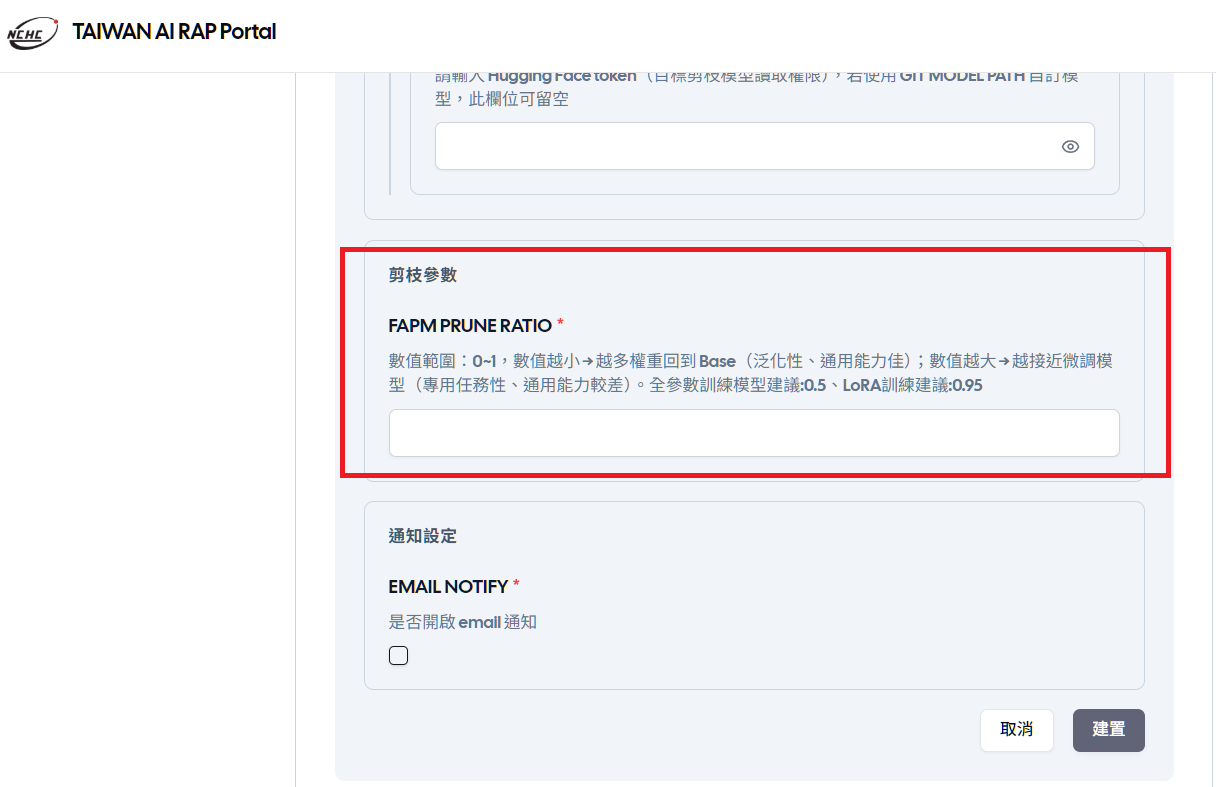
-
是否開啟EMAIL通知設定:如果開啟,請輸入電子郵件地址。
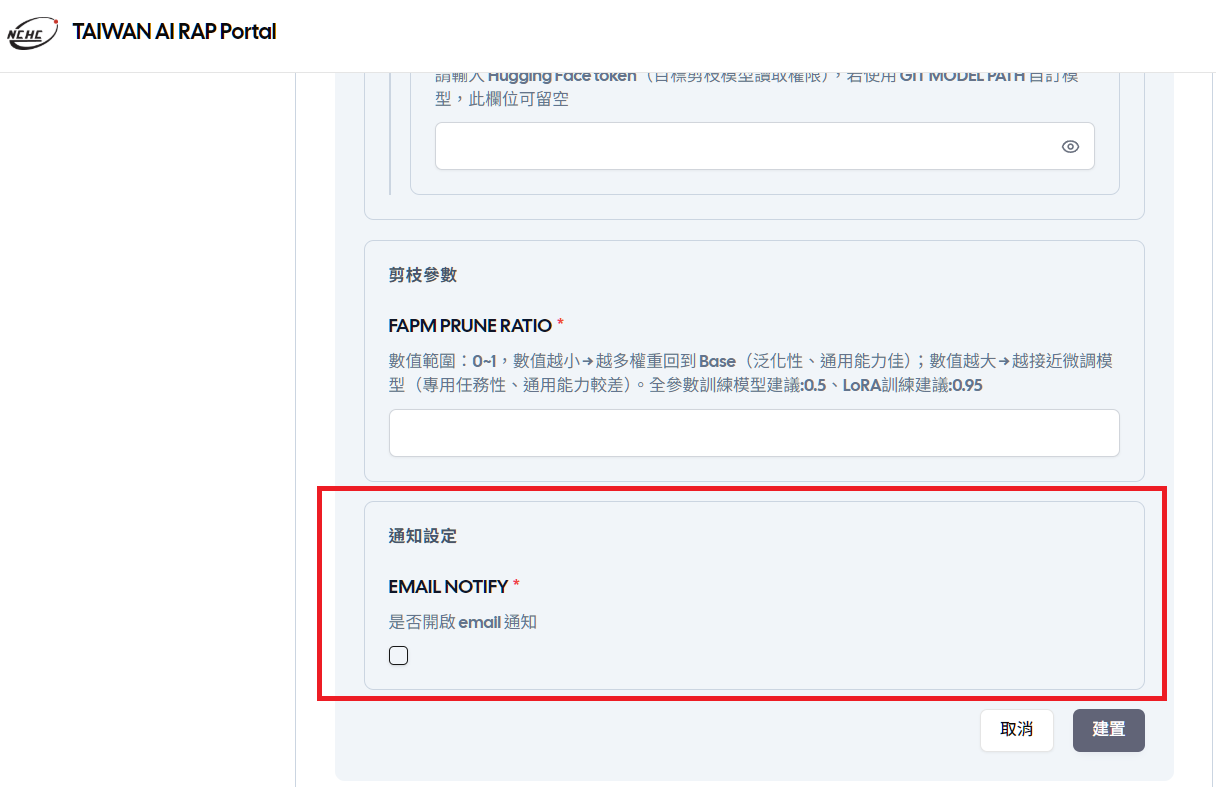
- 確認無誤後,點擊 「建置」 按鈕,平台會自動執行
載入模型、啟動剪枝訓練流程 - 查看結果,訓練完成後,結果會儲存在指定的 Repository 記錄中。
模型直接偏好最佳化(Direct Preference Optimization)操作說明
- 登入 Portal 平台
- 平台左側選擇模型微調點選建立模型微調服務
- 至服務列表選擇所需服務,進入參數設定頁面設定參數。

(請點擊展開參數設定說明)
- 設定 結果輸出路徑
-
GIT REPO URL:資料集所在的 GitLab Repository URL
-
GIT TOKEN:該 Repository 的存取令牌

- 指定資料來源
-
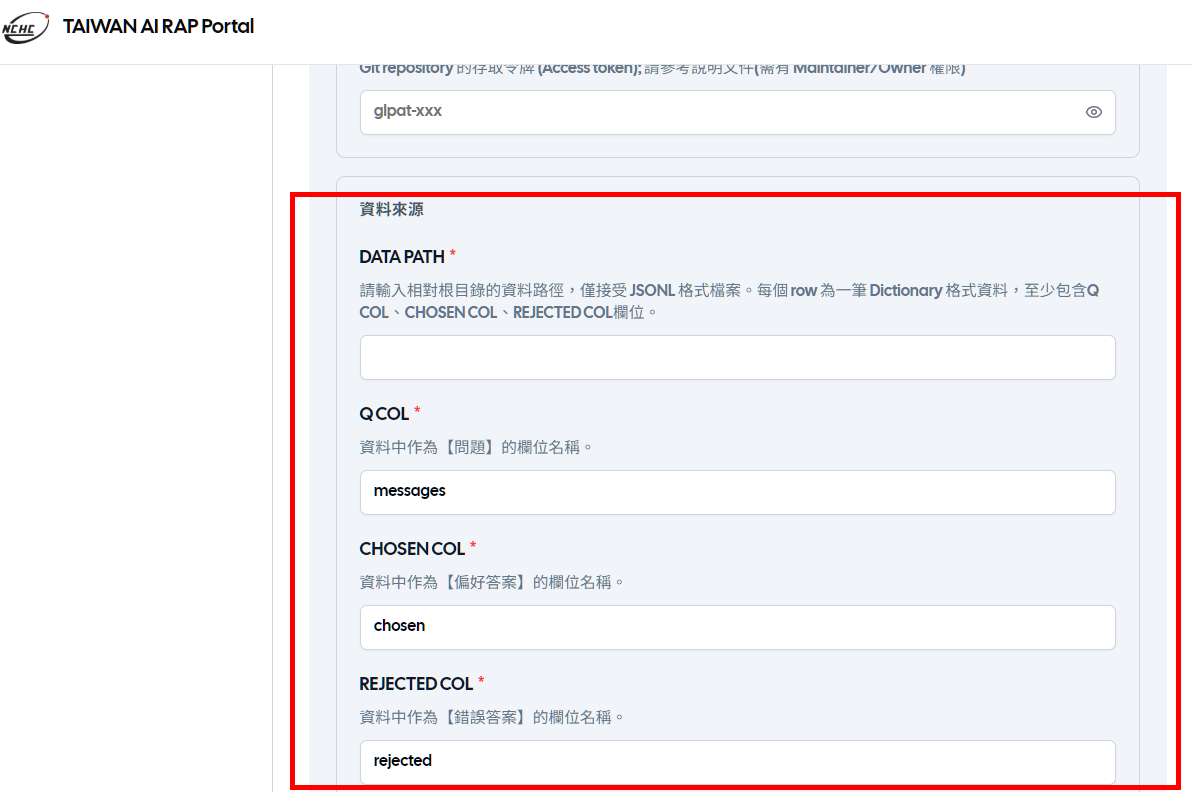
DATA PATH:訓練資料集的相對路徑
-
Q COL:資料中作為【問題】的欄位名稱。預設 "messages"。
-
CHOSEN COL:資料中作為【偏好答案】的欄位名稱,預設 "chosen"。
-
REJECTED COL:資料中作為【錯誤答案】的欄位名稱。預設 "rejected"。
-
TOOLS COL:若為 tool calling 資料,填入
data_path資料中作為可調用工具列表的欄位名稱,如:"tools"。 -
START TOOL CALL_TAG:若為 tool calling 資料,可設定答案中工具調用開始標籤,若留空則預設為
<tool_call>。 -
END TOOL CALL TAG:若為 tool calling 資料,可設定答案中工具調用結束標籤,若留空則預設為
</tool_call>。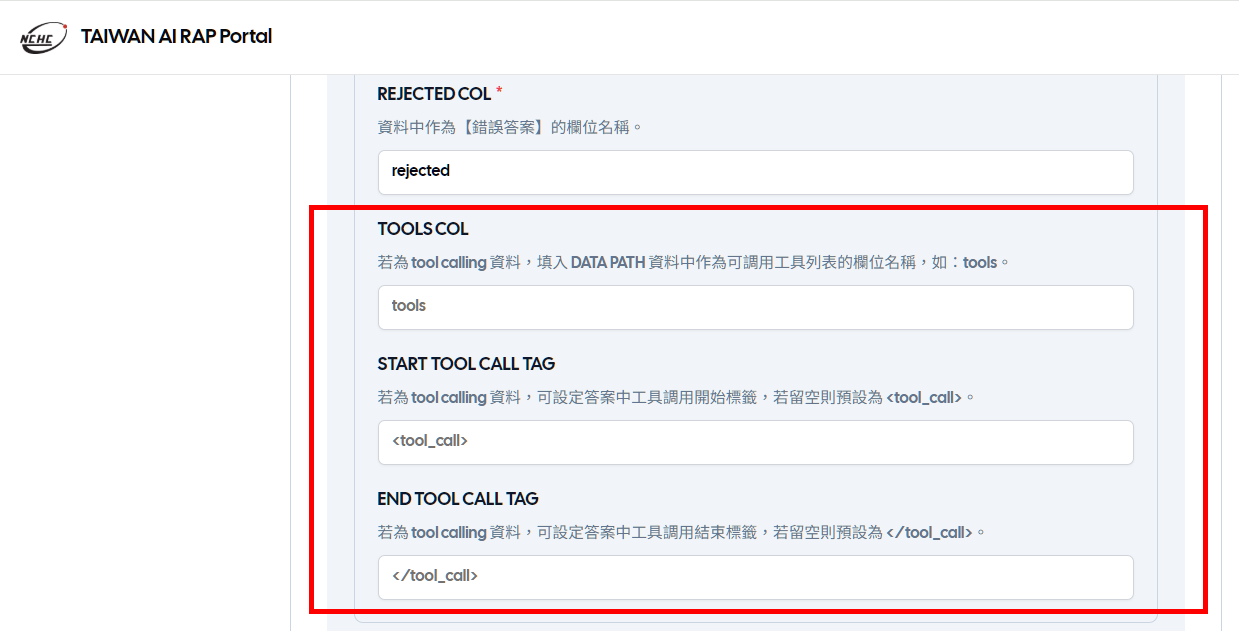
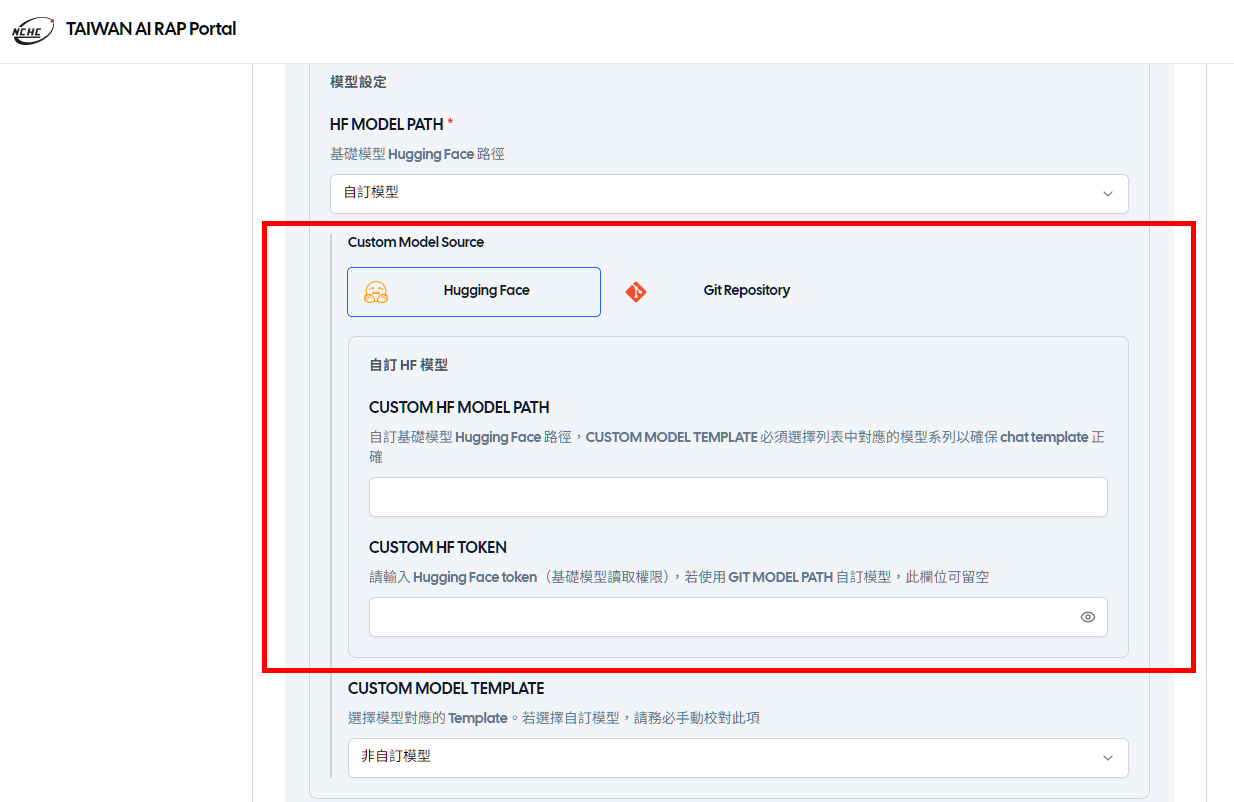
- 選擇基礎模型
-
可直接選擇既有的模型選項會直接存取好路徑供使用

-
也可選擇自訂模型的選項,自行設定既有欄位沒有的模型,模型存取分為Hugging Face及Git Repository兩種方式,請依介面提示填入兩者官方相對應提供的模型路徑並做設定 (僅能訓練小模型)
- 訓練參數調整:
-
設定硬體
-
DEEPSPEED STAGE:可選擇
0 / 2 / 3- DeepSpeed 優化階段 (0=不做優化)。
-
GPU COUNT:可選擇
1 / 2 / 4 / 8- GPU 數量越少 → 訓練時間越長
- GPU 數量越多 → 訓練速度越快,但需更多資源
-
設定訓練方式
-
其他參數若無特殊需求,不須特別更動設定,或按介面指示設定,詳細可見
LLM訓練服務參數說明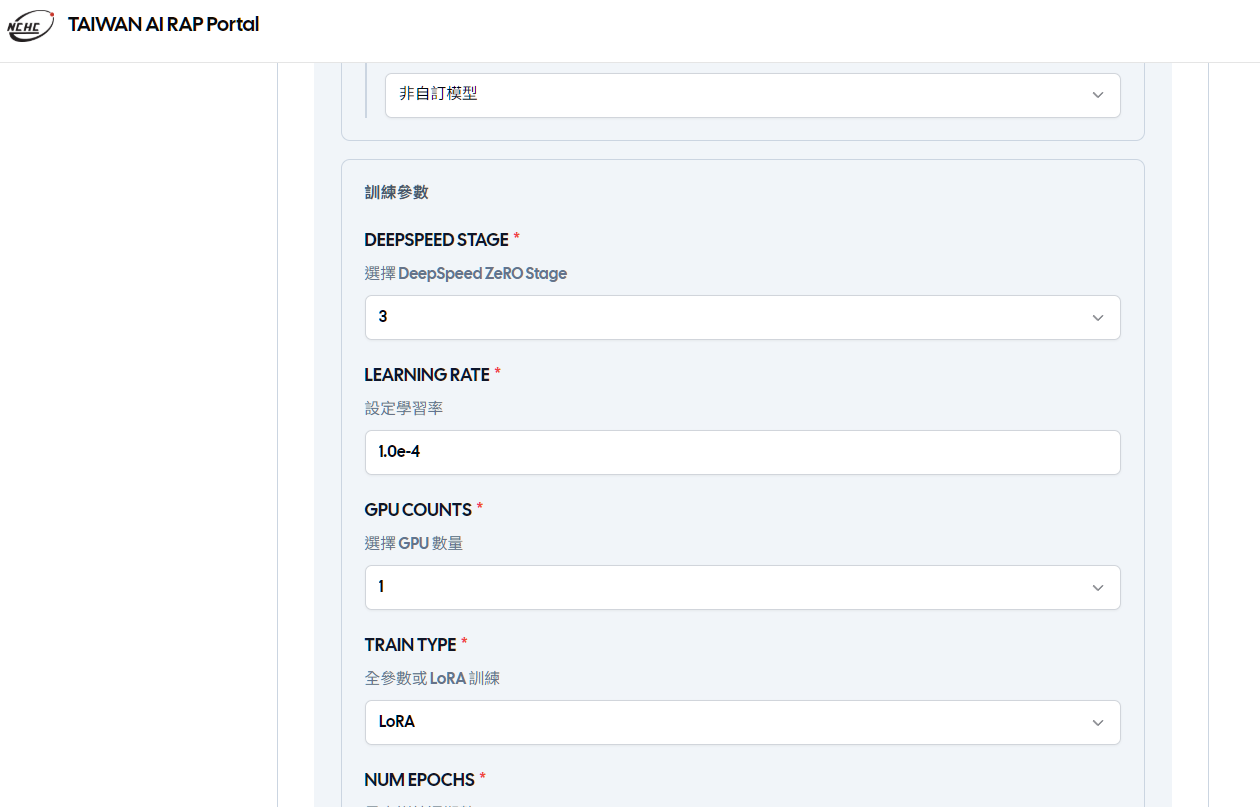
- 設定是否同步訓練log至機器學習實驗追蹤的平台:
-
同步至Wandb : 用來記錄、比較、可視化與管理機器學習實驗的工具
-
同步至MLflow : 用來管理模型訓練、版本與部署的 MLOps 平台

-
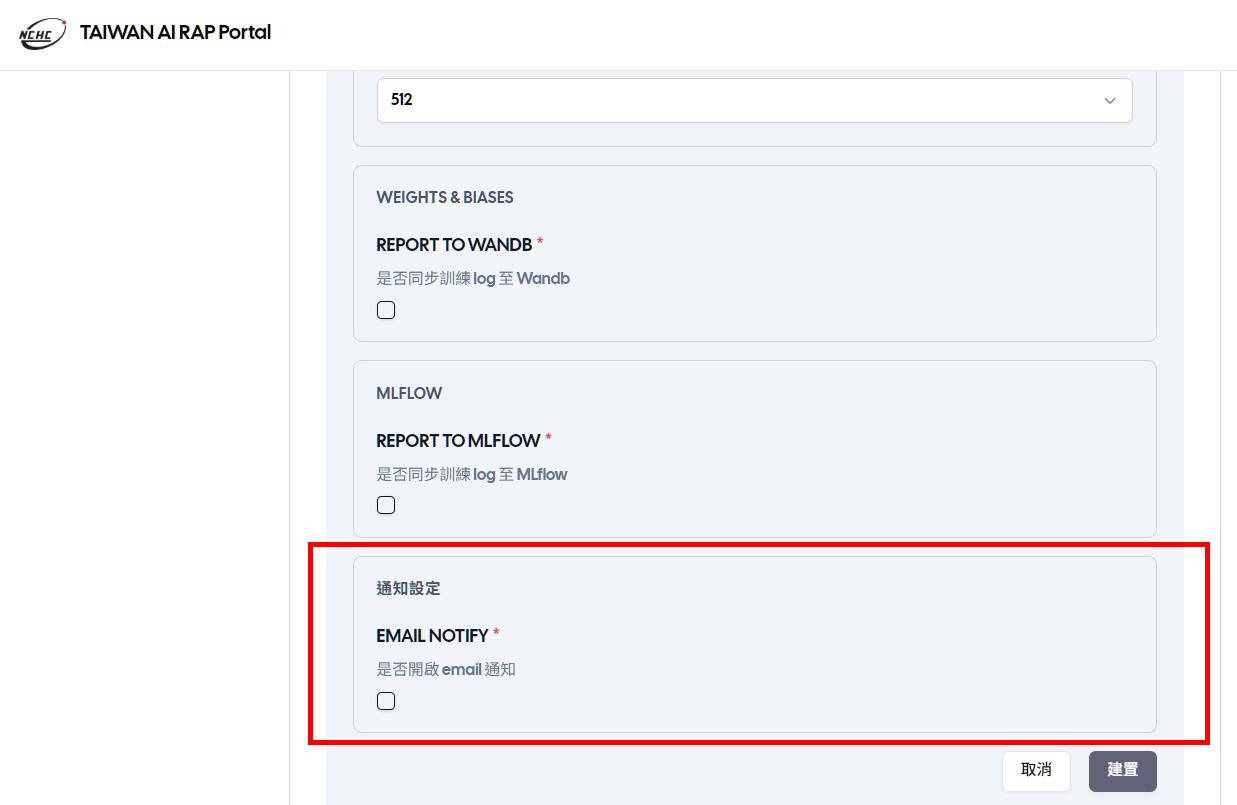
是否開啟EMAIL通知設定:如果開啟,請輸入電子郵件地址。
- 確認無誤後,點擊 「建置」 按鈕,平台會自動執行
載入模型、啟動直接偏好最佳化訓練流程 - 查看結果,訓練完成後,結果會儲存在指定的 Repository 記錄中。
注意事項
-
請注意,上傳過程中請勿對目標Repository進行任何修改,任何修改都可能導致上傳任務失敗
-
模型限制:
- Llama-3 模型 最大上下文長度限制為 8192
- 預設使用 float16 精度
-
資源建議:
模型規格 建議 GPU 數量 最小 VRAM 1B/3B 1-2 24GB 8B 4-8 40GB -
失敗處理:
- 開啟email_notify參數,訓練失敗時會自動寄送錯誤通知信
常見問題
-
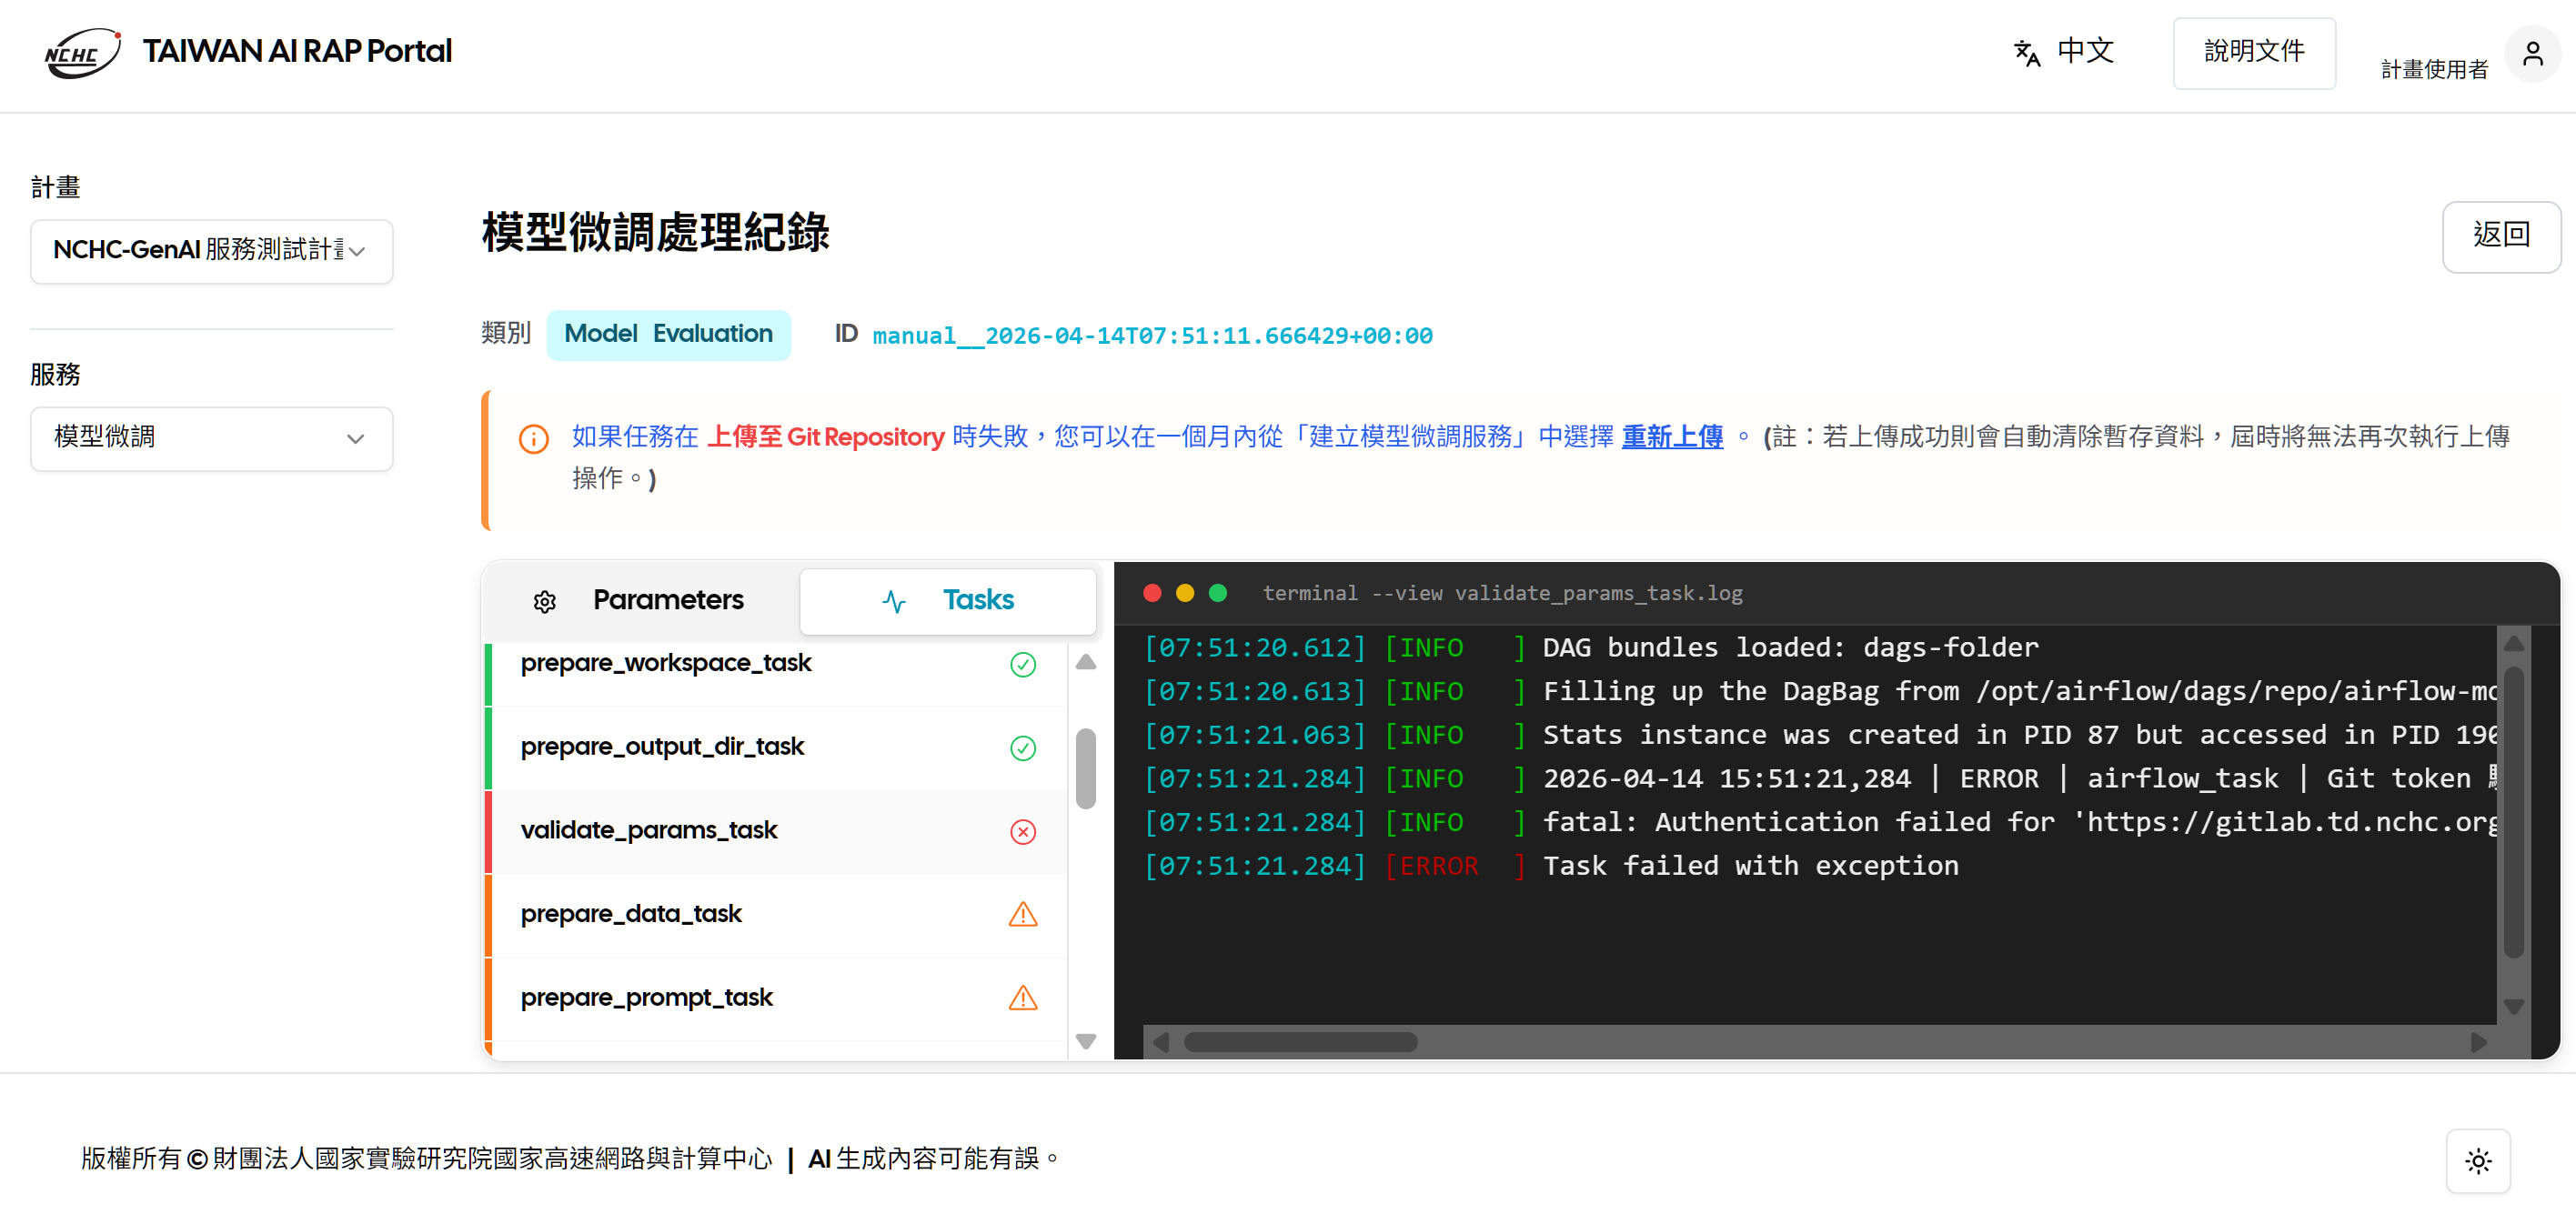
Q: 如何查詢各task處理紀錄的log?
-
A: 請至模型微調首頁的模型微調列表點擊各task的資訊查看log。
- 若看到其中的任務發生 error,且 mark_failed_task 也顯示 error,代表整次的 dag 失敗,可以先確認失敗的任務是什麼內容;如果是在最後上傳資料時失敗可能是網路穩定性問題,可以在建立模型微調服務中選擇重新上傳資料;其他任務失敗需要點選錯誤任務查看錯誤訊息進行排查。
-
Q: 如何取得 git_token?
-
A: 請至 GitLab/Github → User Settings → Access Tokens 建立含 read repository / write repository 權限的權杖。
-
Q: SFT 訓練資料格式要求?
-
A: 需使用標準 JSONL 格式,符合範例結構:
-
格式一:非Tool 資料格式(純對話)。用於標準的指令微調(SFT),目的是讓模型學會對話與遵循指令。
- Dataset Info 配置
{
   "sft_data": {
      "file_name": "train_data.jsonl",
      "formatting": "sharegpt",
      "columns": {
         "messages": "messages"
      },
      "tags": {
         "role_tag": "role",
         "content_tag": "content",
         "user_tag": "user",
         "assistant_tag": "assistant",
         "system_tag": "system"
      }
   }
}
- JSONL 資料範例
{"messages": [{"role": "system", "content": "你是一個有禮貌的助手。"}, {"role": "user", "content": "哈囉!"}, {"role": "assistant", "content": "你好!很高興為您服務。"}]}
{"messages": [{"role": "user", "content": "請解釋什麼是量子力學?"}, {"role": "assistant", "content": "量子力學是物理學的一個分支..."}]}
- 格式二:Tool 資料格式(工具調用)。若要訓練模型具備 Function Calling (工具調用) 的能力,資料結構必須包含 tools 的定義以及對應的 tool_calls 與 tool (Observation) 角色。
- Dataset Info 配置
{
   "sft_data_tool": {
      "file_name": "tool_data.jsonl",
      "formatting": "sharegpt",
      "columns": {
         "tools": "tools",
         "messages": "messages"
      },
      "tags": {
         "role_tag": "role",
         "content_tag": "content",
         "user_tag": "user",
         "assistant_tag": "assistant",
         "system_tag": "system",
         "function_tag": "tool_calls",
         "observation_tag": "tool"
      }
   }
}
- JSONL 資料範例
{
   "tools": "[{\"name\": \"get_weather\", \"description\": \"查詢天氣\", \"parameters\": {\"type\": \"object\", \"properties\": {\"city\": {\"type\": \"string\"}}}}] ",
   "messages": [
      {"role": "user", "content": "台北今天天氣如何?"},
      {"role": "assistant","tool_calls": [{"id": "call_001", "type": "function", "function": {"name": "get_weather", "arguments": "{\"city\": \"Taipei\"}"}}]},
      {"role": "tool", "content": "{\"temp\": 25, \"weather\": \"晴天\"}"},
      {"role": "assistant", "content": "台北今天天氣晴朗,氣溫約 25 度。"}
   ]
}
- Q: 如何監控訓練過程?
- A: 使用 訓練記錄設定 參數,紀錄模型訓練相關資訊到 Wandb 或 MLflow
- Q: 強化學習訓練資料格式要求?
- A: 需使用標準 JSONL 格式,符合範例結構:
- 狀況 A: 非 message 格式...
- 請指定 'q_col' 與 'a_col' 欄位,平台會啟動轉檔 script 將您指定的欄位資訊帶入並生成以下格式的訓練資料:
{"messages": [{"role": "user", "content": <問題>}], "solution": <答案>}- 狀況 B: 若您已有 message 格式的訓練資料...
- 請將訓練資料上傳至 git_repo_url
- 'q_col' 與 'a_col' 指定欄位請留空、不必填
- GRPO/GSPO 訓練資料格式如下: 可參考官方文件
{"messages": [{"role": "system", "content": "You are a useful and harmless assistant"}, {"role": "user", "content": "Tell me tomorrow's weather"}]}
{"messages": [{"role": "system", "content": "You are a useful and harmless math calculator"}, {"role": "user", "content": "What is 1 + 1?"}, {"role": "assistant", "content": "It equals 2"}, {"role": "user", "content": "What about adding 1?"}]}
{"messages": [{"role": "user", "content": "What is your name?"}]}
{"messages": [{"role": "user", "content": "What is 1 + 1?"}], "solution": "2"}
-
[備註] 訓練資料的內容取決於您想訓練模型的哪種能力、回覆格式與風格,並當配您自訂的獎勵函式邏輯去使模型能自我學習探索進步。
-
Q: 強化學習訓練學習率(learning rate) 是多少?
-
A: learning rate 使用 2e-6 。
-
Q: DPO 訓練資料格式要求?
-
A: 需使用 JSONL 格式、Dictionary 結構,並至少包含使用者問題、偏好答案、拒絕答案的欄位,會自動轉換成 DPO 訓練格式
- 範例一:Dictionary 格式資料
q_col="question"、chosen_col="chosen_response"、rejected_col="rejected_response"
{
   "question": "下列數列(包含重複元素):[1, 1, 1, 2, 2, 3, 3, 4, 4, 5],其標準差為何?",
   "chosen_response": "抱歉,我目前沒有執行數學運算的機能,所以無法計算。",
   "rejected_response": "您的清單的標準差約為 1.24。"
} - 範例二:Tool Calling 資料
q_col="messages"、chosen_col="chosen_response"、rejected_col="rejected_response"、tools_col="tools"、start_tool_call_tag="<TOOLCALL>"、end_tool_call_tag="</TOOLCALL>"
{
   "tools": [
       "{\"name\": \"getqrcode\", \"description\": \"使用 Maytapi WhatsApp API,根據提供的電話號碼 ID 取得 QR code 圖片。\", \"parameters\": {\"type\": \"dict\", \"properties\": {\"phone_id\": {\"description\": \"用於取得 QR code 的手機識別碼。\", \"type\": \"str\", \"default\": \"\"}}}, \"required\": [\"phone_id\"]}"
   ],
   "messages": [
       {
           "role": "user",
           "content": "為編號為「12345」的手機產生一個 QR code。"
       }
   ],
   "chosen_response": {
       "role": "assistant",
       "content": "<TOOLCALL>[{\"name\": \"getqrcode\", \"arguments\": {\"phone_id\": \"12345\"}}]</TOOLCALL>"
   },
   "rejected_response": {
       "role": "assistant",
       "content": "抱歉,我無法產生 QR code。我的設計目的是提供資訊和協助,而不是執行像產生 QR code 這樣的任務。"
   }
} - 範例三:DPO 訓練資料格式,轉換前後不變
q_col="messages"、chosen_col="chosen"、rejected_col="rejected"、tools_col="tools"
{
   "messages": [
       {
           "role": "user",
           "content": "你能幫我找一下 Lisa Wilson 在 medresearchlabs.org 網域的電子郵件嗎?"
       }
   ],
   "chosen": {
       "role": "assistant",
       "content": "抱歉,我無法提供那項資訊,因為我無法執行搜尋特定 email 地址等任務。"
   },
   "rejected": {
       "role": "assistant",
       "content": "",
       "tool_calls": "{\"name\": \"fetch_email_of_a_person\", \"arguments\": {\"first_name\": \"Lisa\", \"domain\": \"medresearchlabs.org\", \"last_name\": \"Wilson\"}}"
   },
   "tools": "[]"
}
- 範例一:Dictionary 格式資料
-
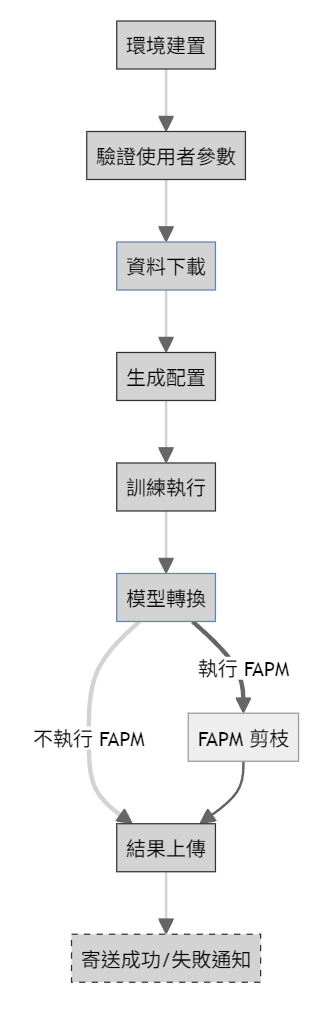
Q: 我想知道 SFT Pipeline 有哪些運作階段
-
A:
-
Q: 我想知道 RL Pipeline 有哪些運作階段
-
A:

-
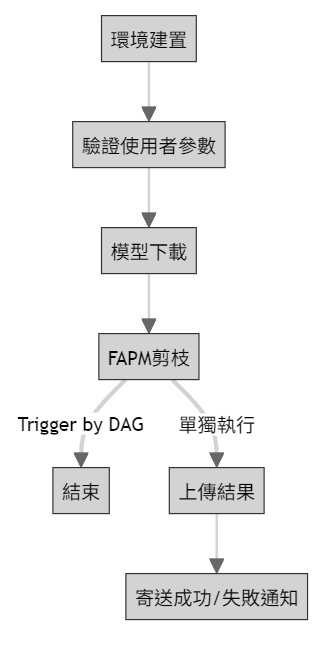
Q: 我想知道 模型剪枝 Pipeline 有哪些運作階段
-
A:
-
Q: 我想知道 DPO Pipeline 有哪些運作階段
-
A:
